オンプレ AI モデル活用
バーチャルヒューマン、AI 動画、ナレーションと音楽を自社の GPU で生成
オープンモデルをお客様の GPU サーバーに構築します。バーチャルヒューマンごとに専用 LoRA を学習させるので、シーンや衣装が変わっても同じ顔のまま。日常のショート動画を撮り、ショートドラマを演じ、セリフは本人の声でリップシンクします。テーマ・ニュース記事・スライドからナレーションと字幕付きの動画を作り、専用音声の学習、BGM の生成、録音の文字起こしにも対応します。画像・動画・音声はお客様のマシンで生成し、従量課金もありません。
生成した動画
このプラットフォームで実際に生成した動画です。最初の 1 本は AI 広告、次の 3 本はバーチャルキャラクターが話す動画(キャラクターの声でセリフを読み、口の動きを合わせ、字幕付き)、最後の 3 本はバーチャルヒューマンのキーフレーム 1 枚を最初のフレームにした画像から動画(MiniMax H3)で、各 5 秒・編集なしです。
AI 広告:3 歳の子どもと関西を旅する家族旅行の広告。58 秒・11 シーンで、各シーンに見出しと字幕が入り、最後は「旅程表を請求」で締めくくります。 あいさつ:レコード店でカメラに向かって自己紹介し、フォローを呼びかける 8 秒のセリフ。字幕も声に合わせて表示されます。 リップシンクのアップ:眼鏡の男性がカメラに向かって話します。ここまで寄っても口の動きと声が合っています。 週末の Vlog:公園を歩きながら、ペースを落とす 3 つのコツを話す 37 秒。カットが変わっても顔と声は同じ人のままです。 公園の小道:笑顔でカメラに向かって歩いてきます。顔・服・光は最初のキーフレームと一致しています。 荷造り:スーツケースに手を添え、うつむいて笑ってからカメラを見上げます。部屋と朝の光は最後まで崩れません。 カフェ:カップを持ち上げて一口飲み、カメラがゆっくり寄って笑顔に。BGM と環境音もモデルが同時に生成しています。
向いている方
- 画像・音声・動画を大量に出すため、従量課金のクラウドでは合わなくなった
- 録音・映像・書き起こしが機微情報で、第三者に渡せない
- ブランドの声や出演者の見た目を毎回そろえたい
向いていない方
- 月に数本だけなら、既製のクラウドのほうが安く済みます
- 声や肖像の利用許諾が無い
納品物
- 01バーチャルヒューマン:権利のある素材で専用キャラクター LoRA を学習。シーンや衣装が変わっても同じ顔で、声と人物設定も用意
- 02バーチャルヒューマン動画:縦型の日常ショート動画、または 2~4 人が同じ画面に登場するショートドラマ。セリフはそれぞれの声でリップシンクし、台本・絵コンテ・画像の各段階で止めて修正可能
- 03AI 動画制作:テーマ、ニュース、ブログ、PDF/スライドから始め、AI が台本を書き、カットを選び、ナレーションと字幕を付けて、タイムラインで仕上げ
- 04生成ワークベンチ:テキストから画像、画像から画像、レタッチ、着せ替え、画像から動画、音楽、音声。モデルは切り替え可能で、成果物はメディアライブラリに自動保存
- 05音声と編集:録音から専用の声を学習。会議やサポート通話をタイムスタンプ・話者分離付きで文字起こし。ポッドキャストや動画の無音と繰り返しを削り、短縮版と字幕を出力
- 06導入とインターフェース:お客様の GPU ホスト、または当社が代理購入するクラウド GPU で稼働。GPU キューと VRAM の監視、API と MCP ツール付き。台本は Claude でも、すべてローカルモデルでも作成可能
実際の画面
「バーチャルヒューマンと AI メディア生成プラットフォーム」の実際の画面です。画像をクリックすると原寸で表示します。
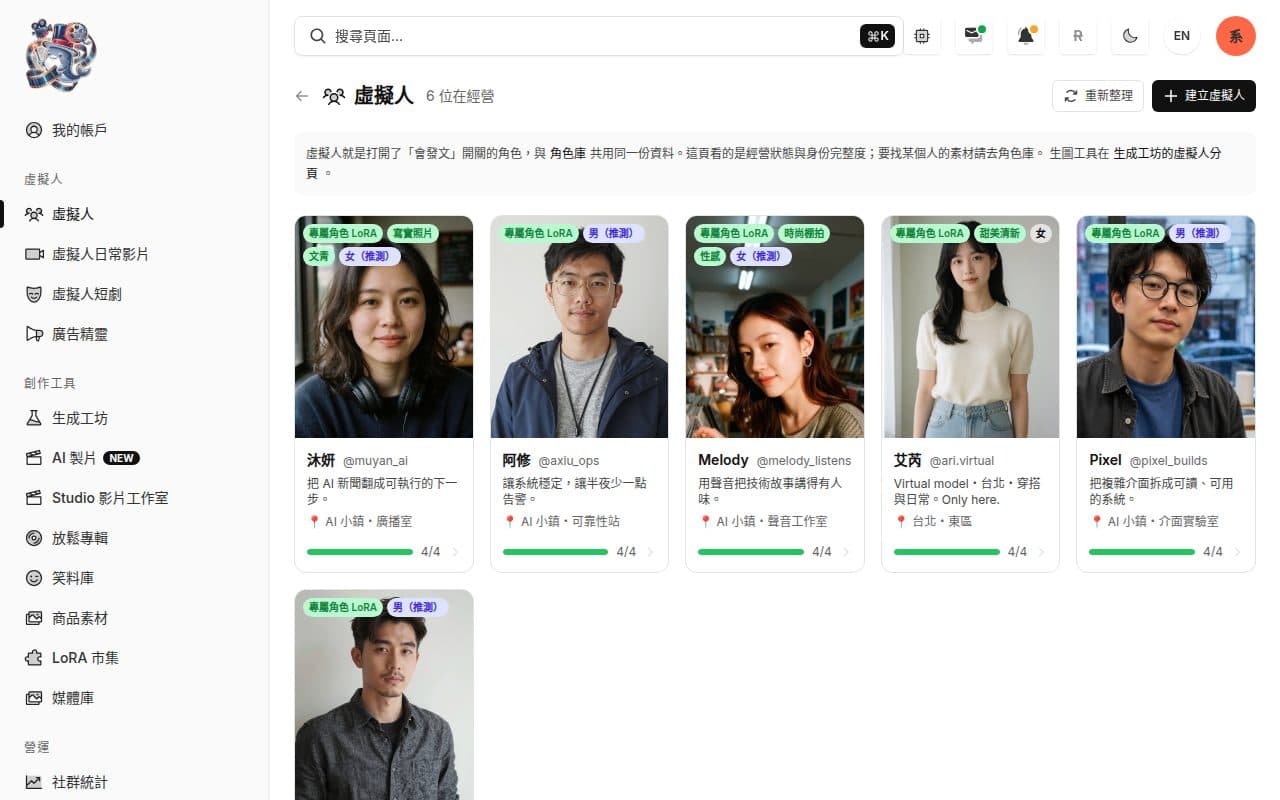
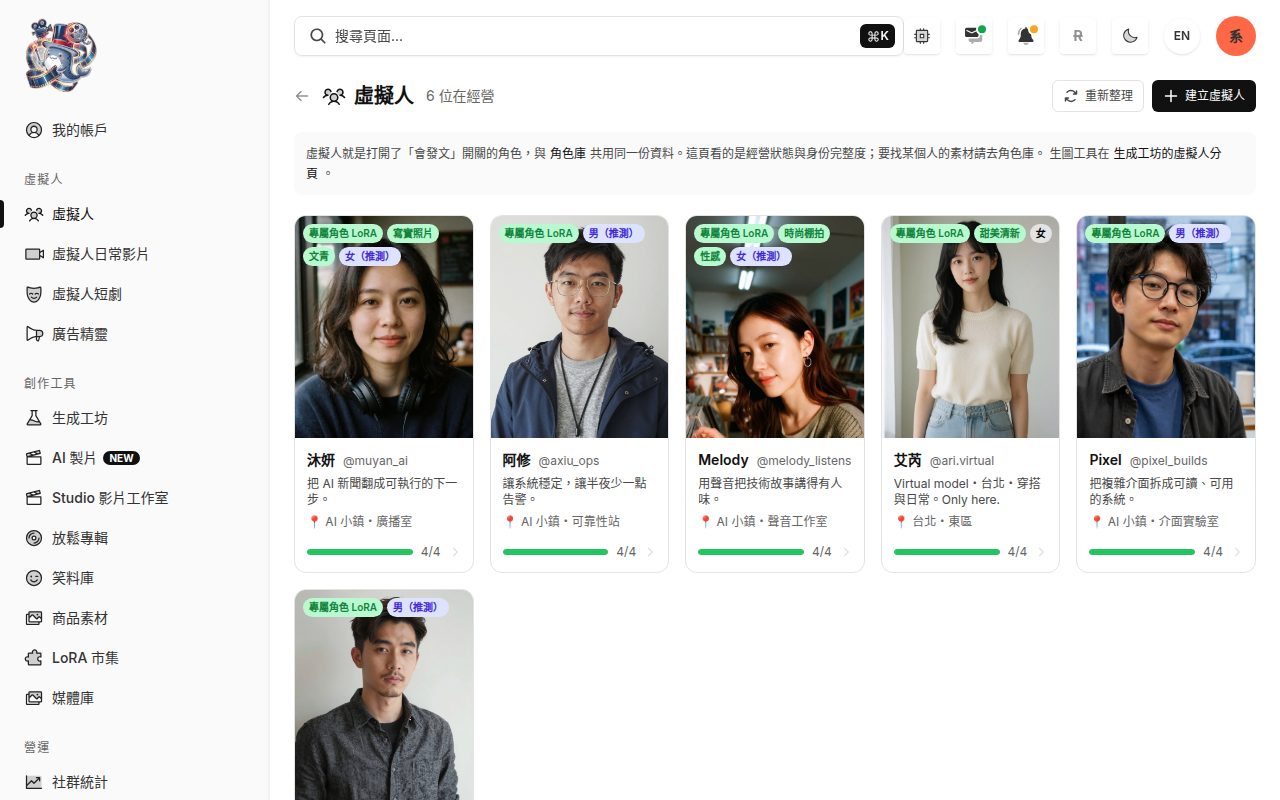
バーチャルヒューマン:キャラクターごとに専用 LoRA、人物設定、SNS アカウントがあり、素材の充足度がひと目でわかります。 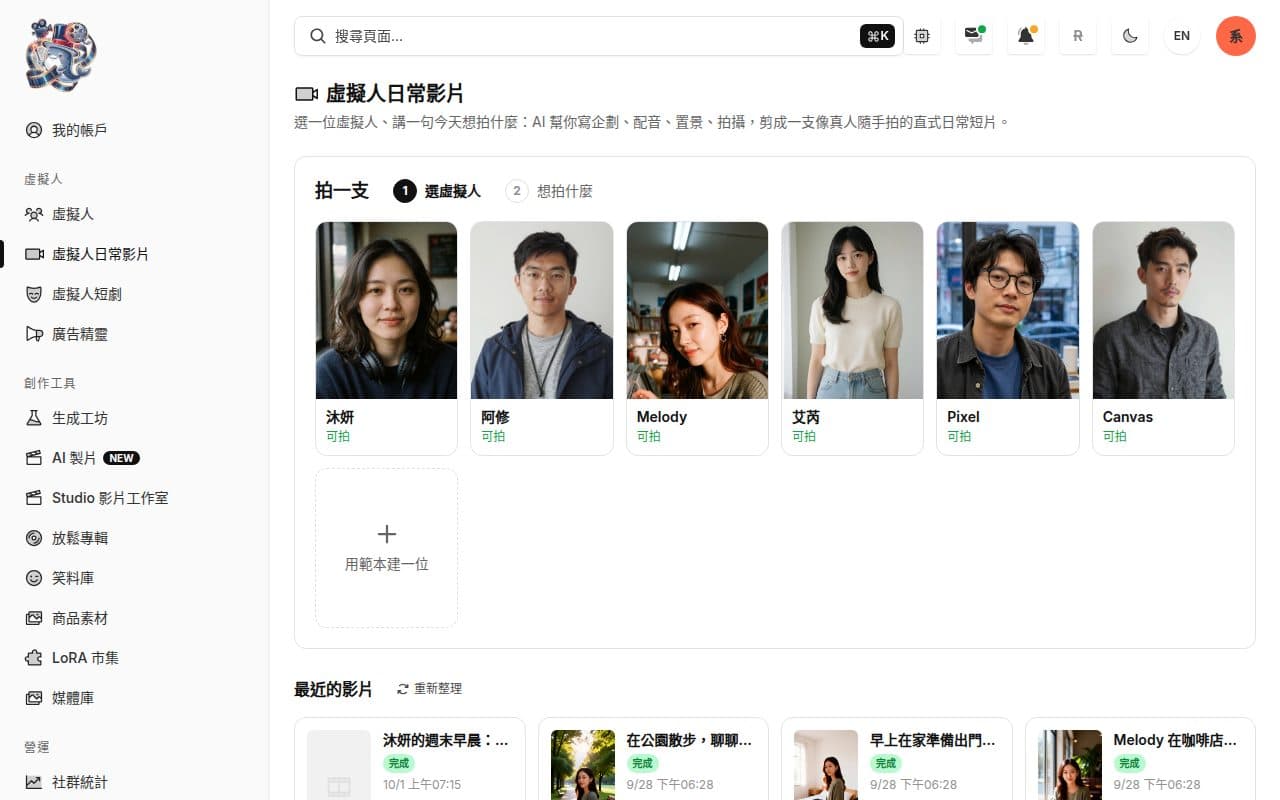
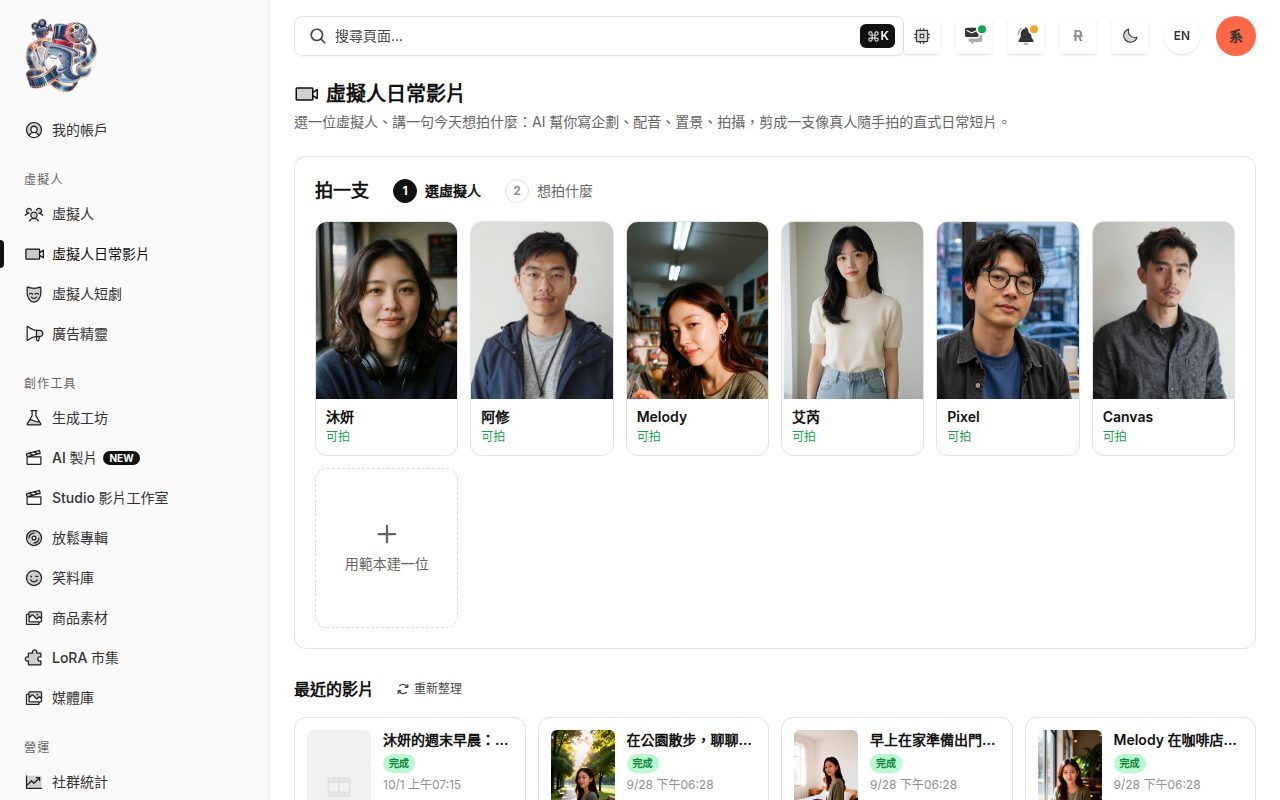
日常動画:バーチャルヒューマンを選び、今日撮りたいことを一言伝えると、手持ち撮影風の縦型動画に仕上がります。 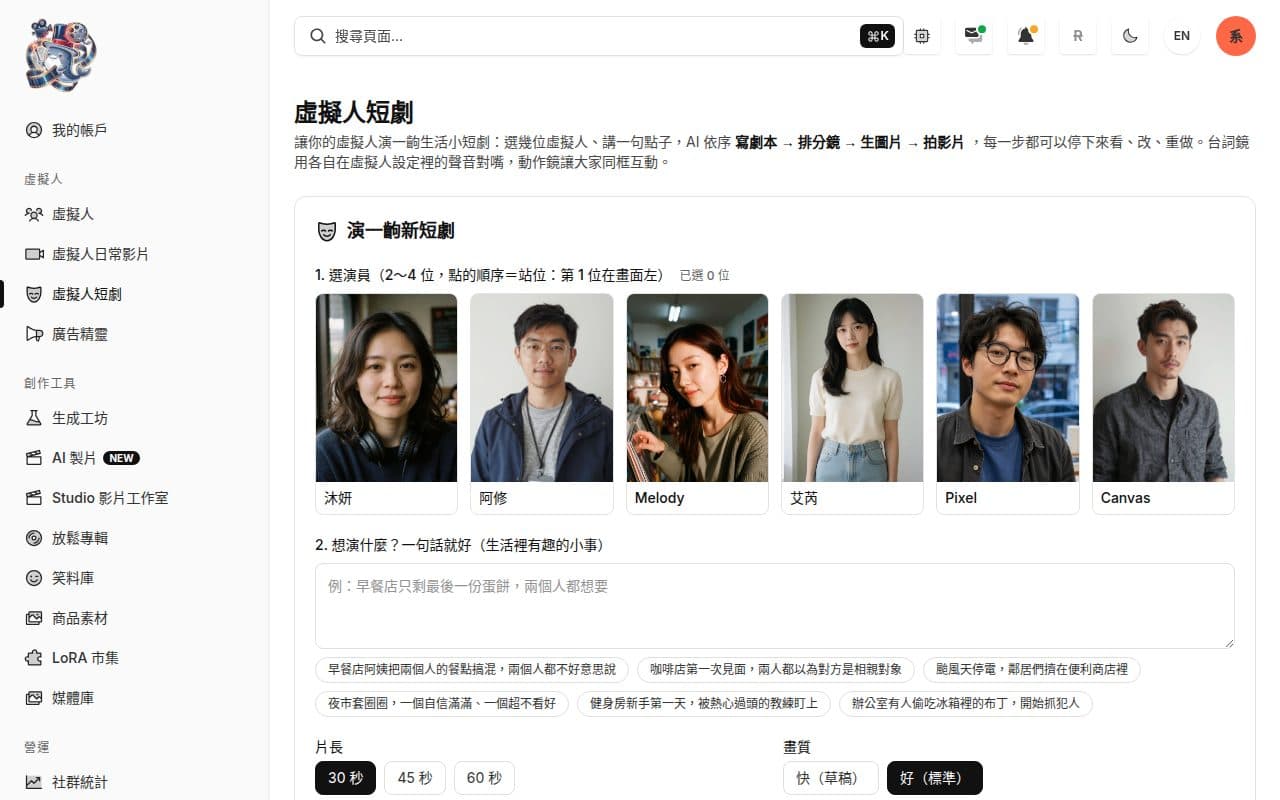
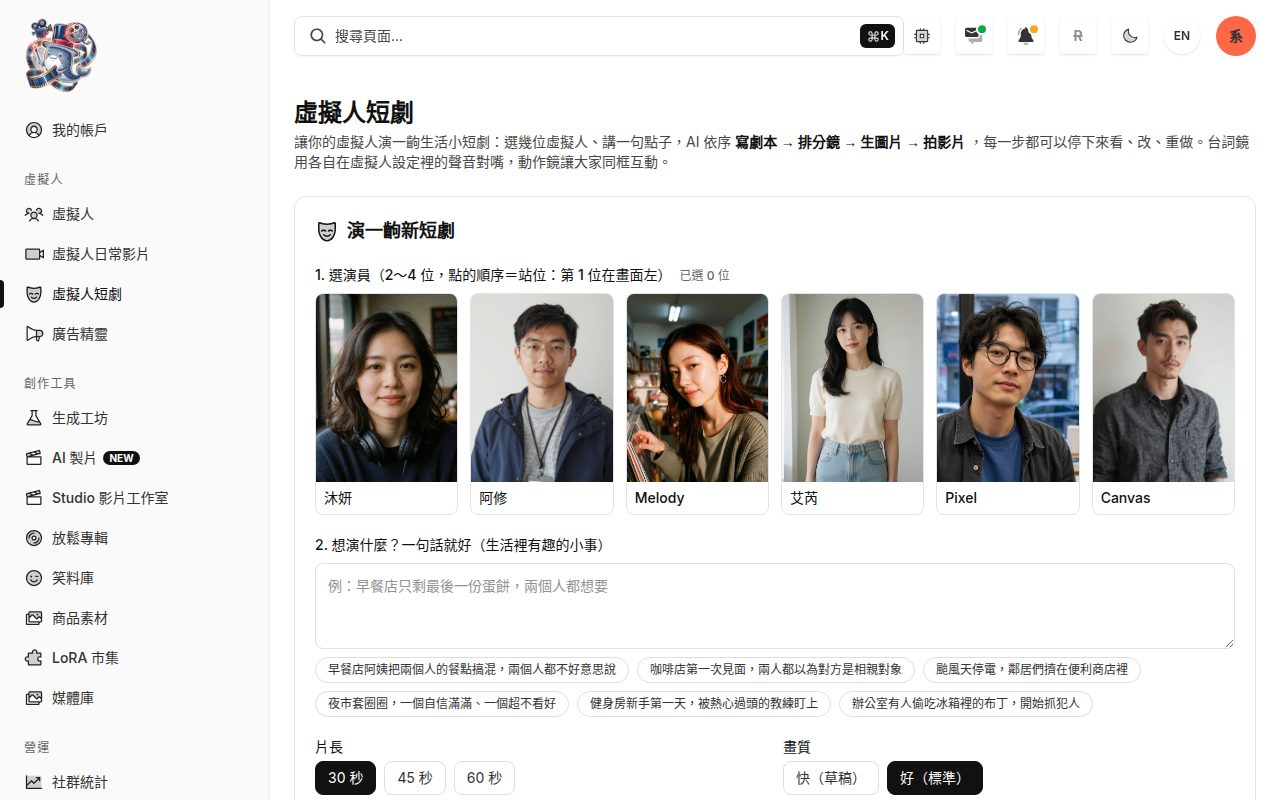
ショートドラマ:出演者 2~4 人とアイデアを一つ選ぶと、台本・絵コンテ・画像・動画を段階ごとに確認できます。 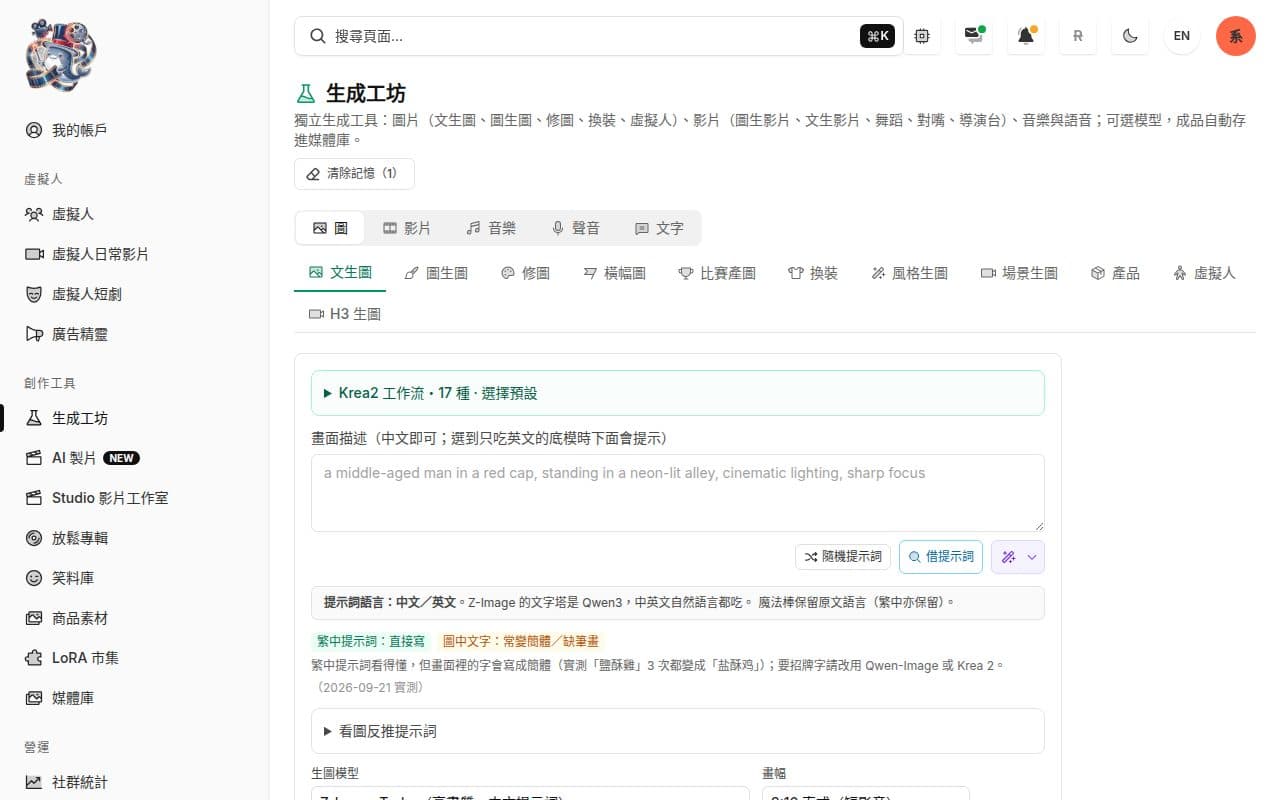
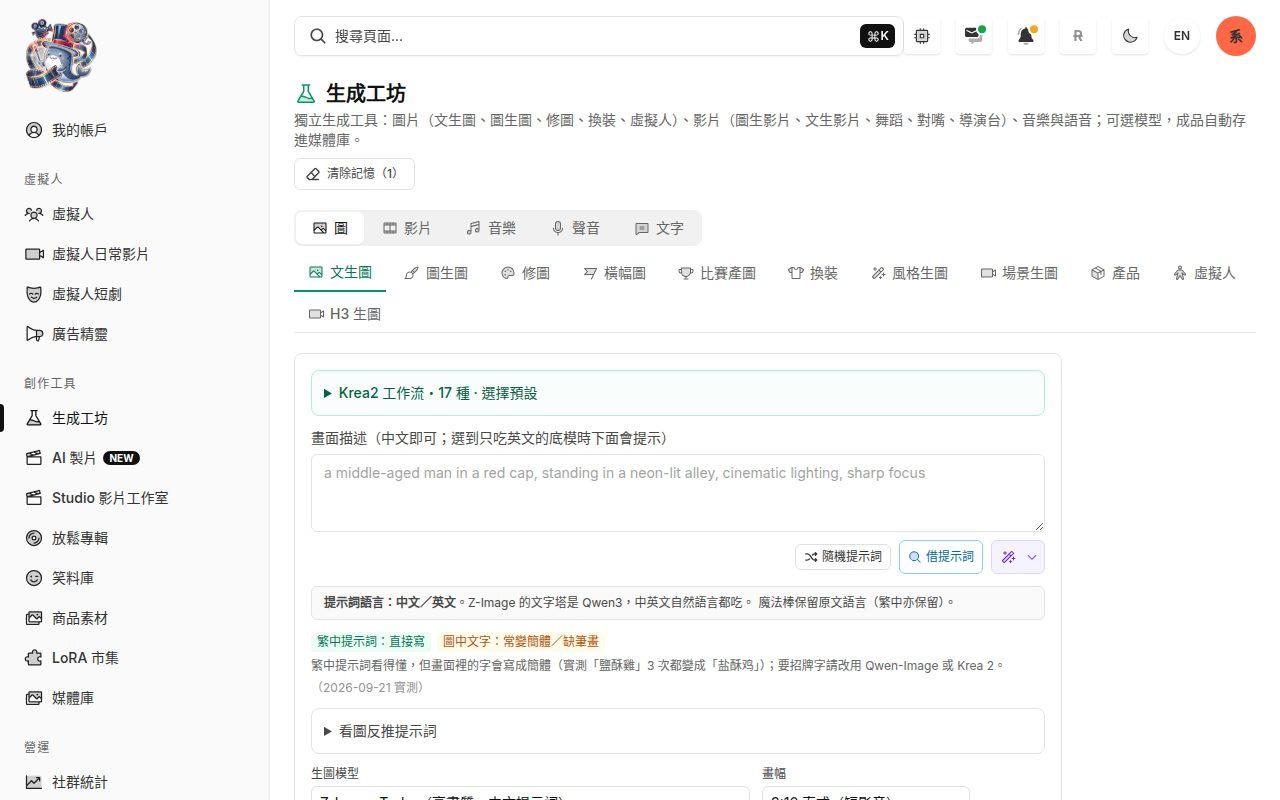
生成ワークベンチ:画像・動画・音楽・音声のタブ。画像モデルを切り替えられ、成果物はメディアライブラリに保存されます。 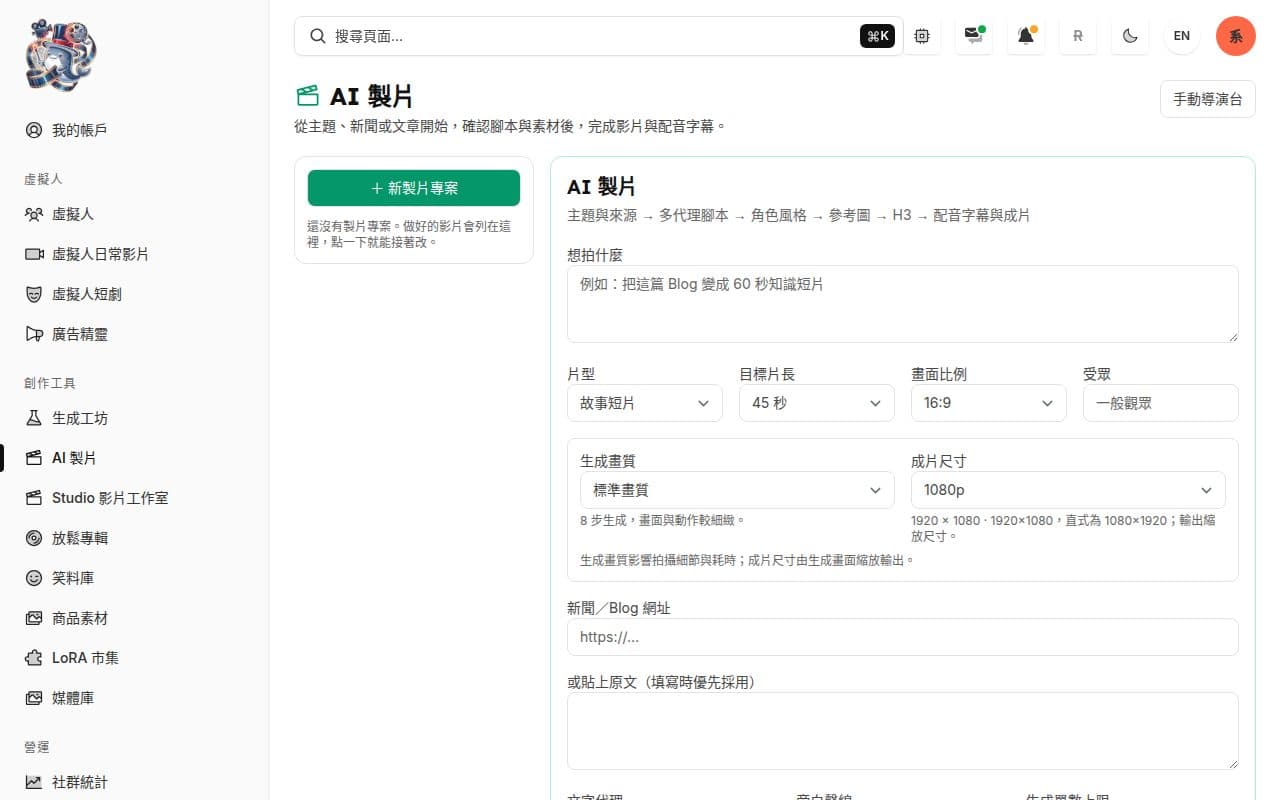
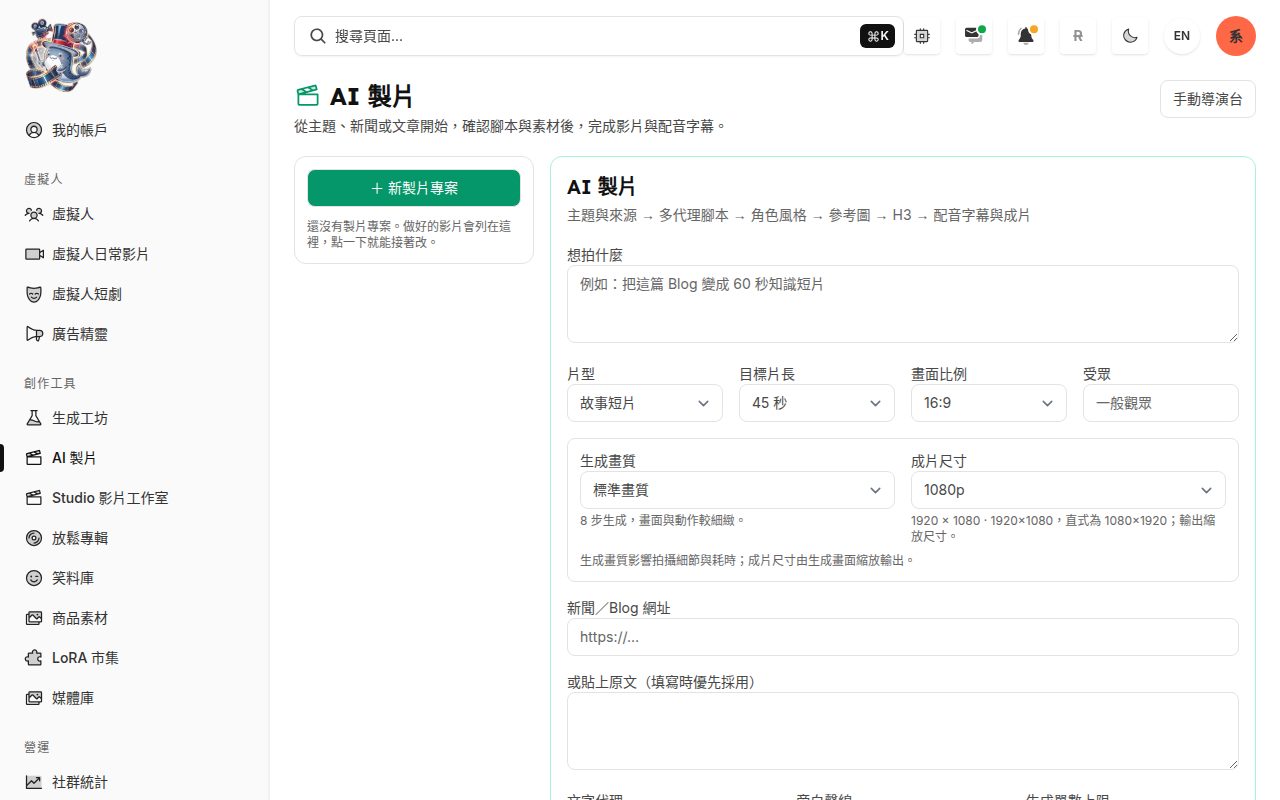
AI 動画制作:テーマ、ニュース、ブログから始め、複数の AI エージェントが台本を書き、ナレーションと字幕を付けて仕上げます。 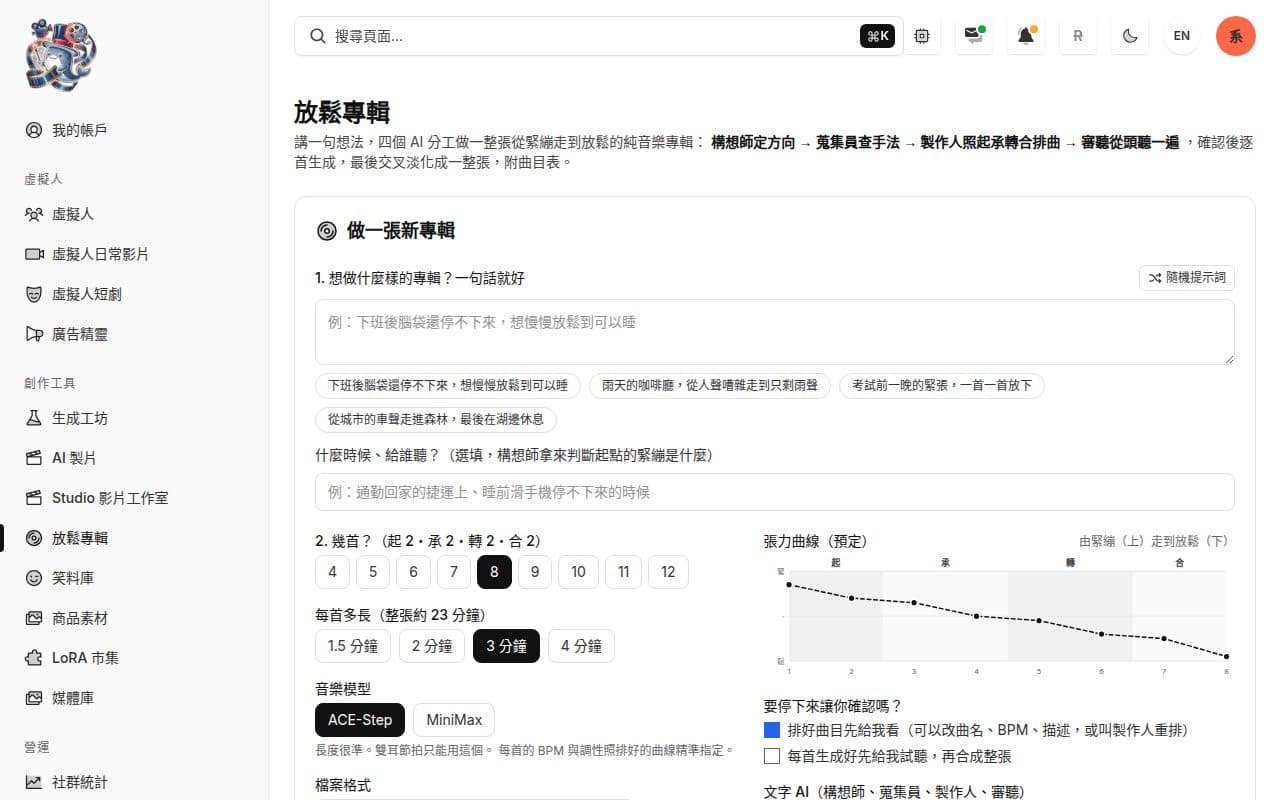
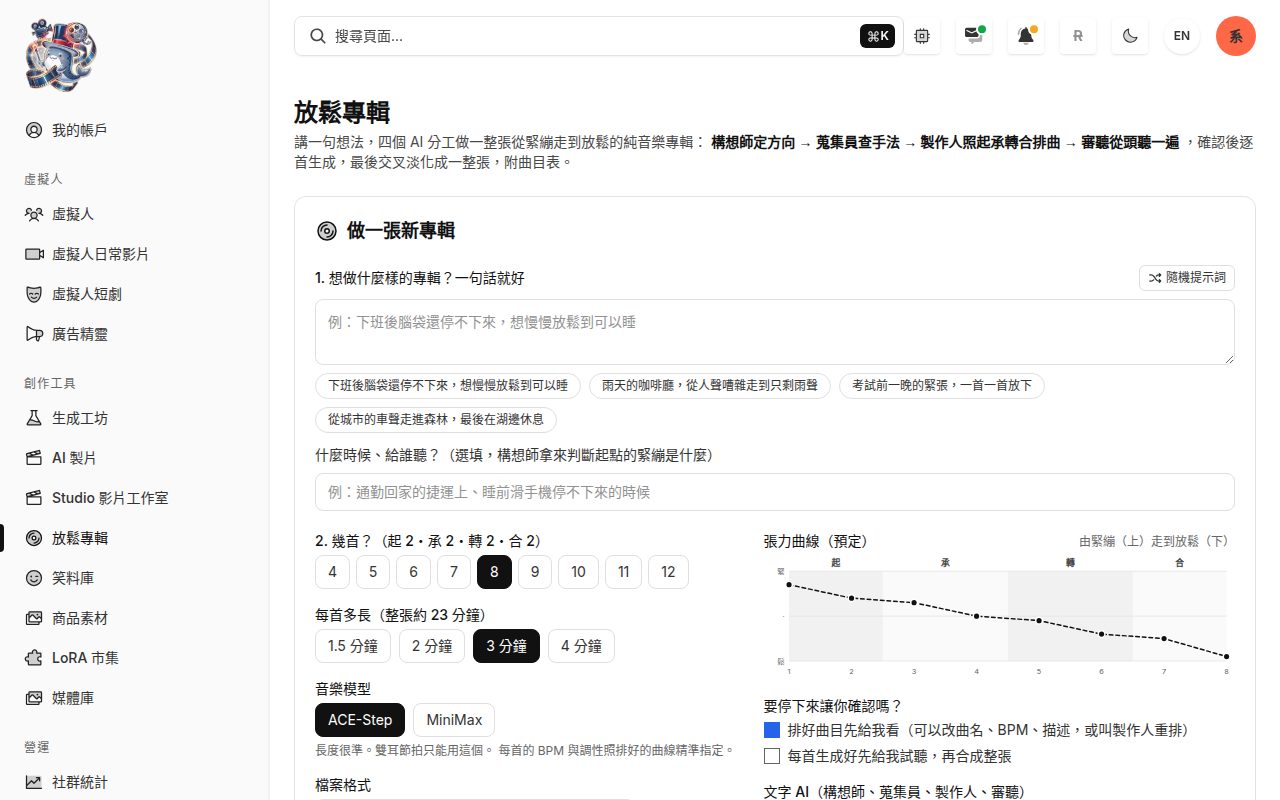
リラックスアルバム:4 つの AI が緊張から落ち着きへ向かう曲順を組み、ACE-Step で 1 曲ずつ生成します。
関連記事
代表者のブログに書いた記事です(英語版)。進め方と途中で起きた問題を記録しています。
関連する実績
このサービスと同じ種類で、自社で運用中または公開済みのものです。
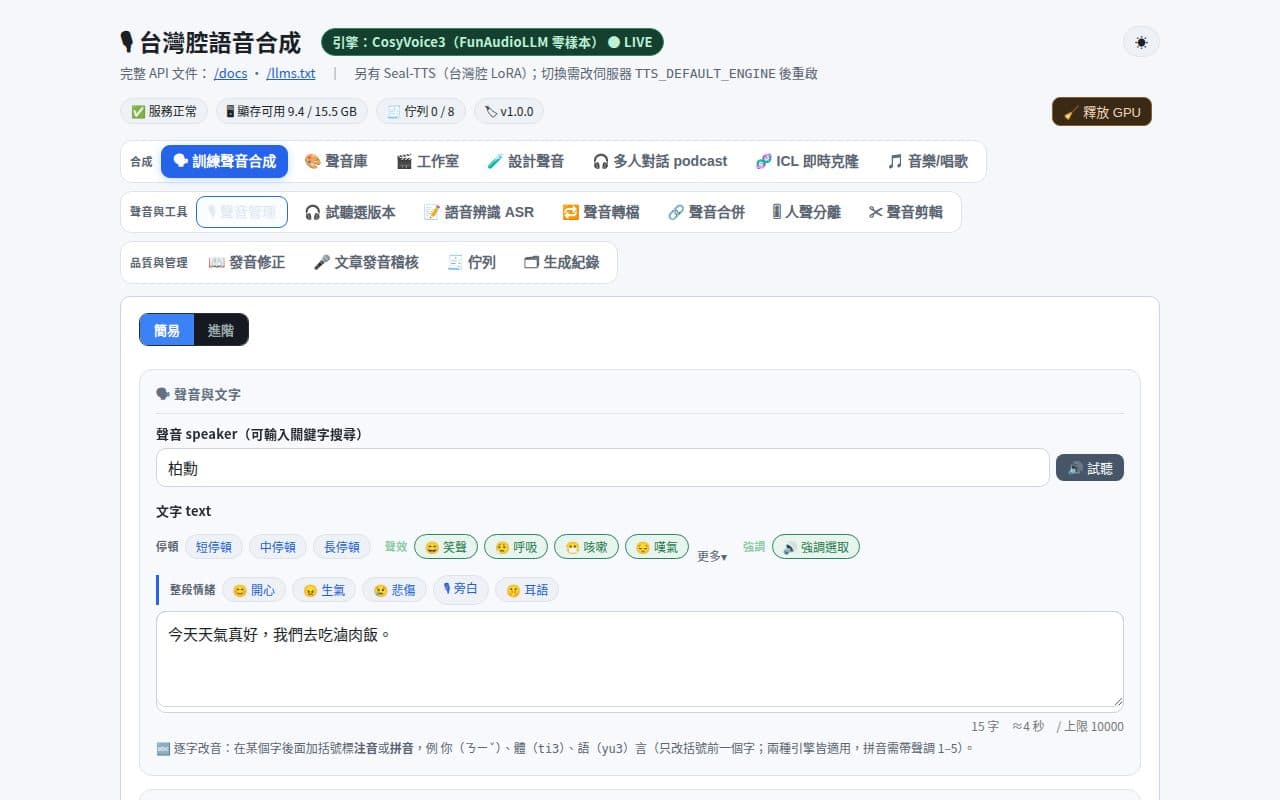
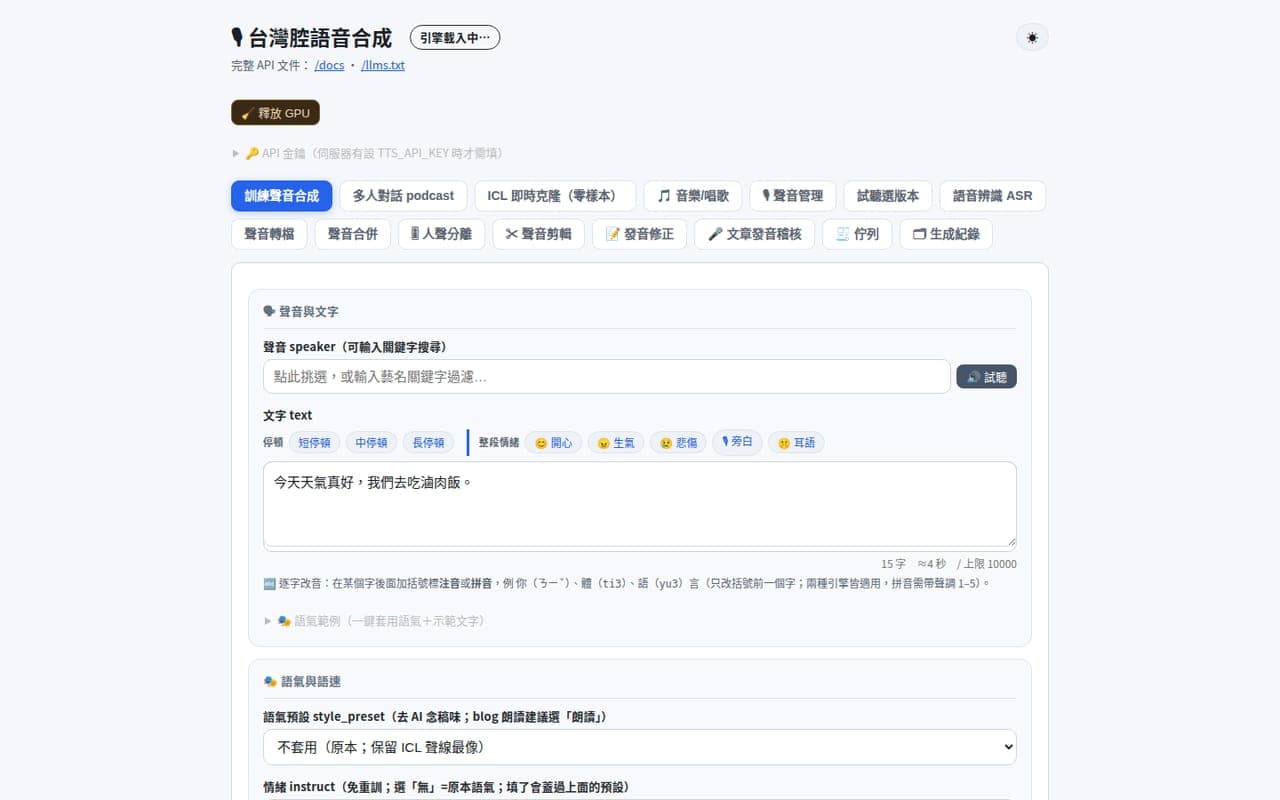
Seal-TTS 台湾なまり音声プラットフォーム
ローカル GPU で動く音声基盤。録音から専用の声を学習、ゼロショットの即時クローン、複数話者の podcast、音声認識、ボーカル分離、発音補正。AgentHub の LINE 音声配信はこれで合成しています。
- Qwen3-TTS
- CosyVoice3
- ローカル GPU
- MCP
podcast のフィラーや言いよどみをカット。ローカルの faster-whisper で認識、demucs でボーカル分離、息づかいを残して音量を整え、書き出し前に継ぎ目を 1 つずつ試聴できます。処理はすべてローカル。
- faster-whisper
- demucs
- Rust
- ffmpeg
- オープンソース
動画の中の物体を、文字入力・クリック・AI 任せのいずれかで選ぶと、フレームごとに追跡してモザイク、画像や動画への差し替え、他のフレームの背景を使った消去ができます。タイムライン編集とローカル字幕も備え、すべて自分の GPU で動きます。
- SAM 2.1
- faster-whisper
- MCP
- ローカル GPU
- MIT