オンプレミスモデル
音声トレーニングとファインチューニング
お預かりした録音から、ローカル GPU 上で専用の声をファインチューニングします。学習済みの声はテキストからそのまま音声を合成でき、安定度・話速・感情を調整できます。台湾華語の読みは修正表で補正します。
このシステムでできること
- 声ごとに adapter を学習し、各エポックの版を保存。同じ文で聴き比べてから採用する版を決めます
- 録音がまだ足りない段階ではゼロショットクローン。3〜15 秒のクリアな音声で最初の試聴版をつくれます
- 台湾華語の読み修正表:語単位の置換と多音字の指定。保存するとすぐ反映されます
- HTTP API と MCP ツールを提供。AgentHub の LINE 音声配信もこれで合成しています
画面を見る
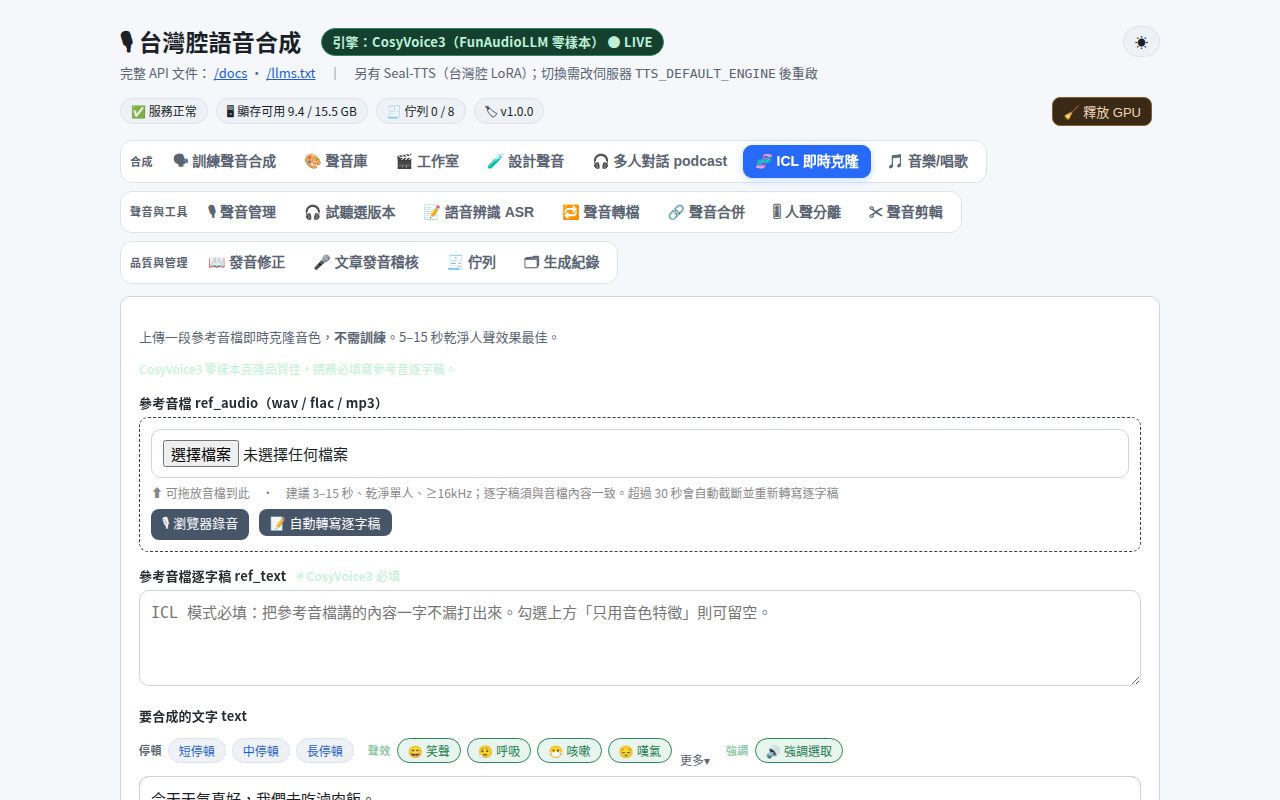
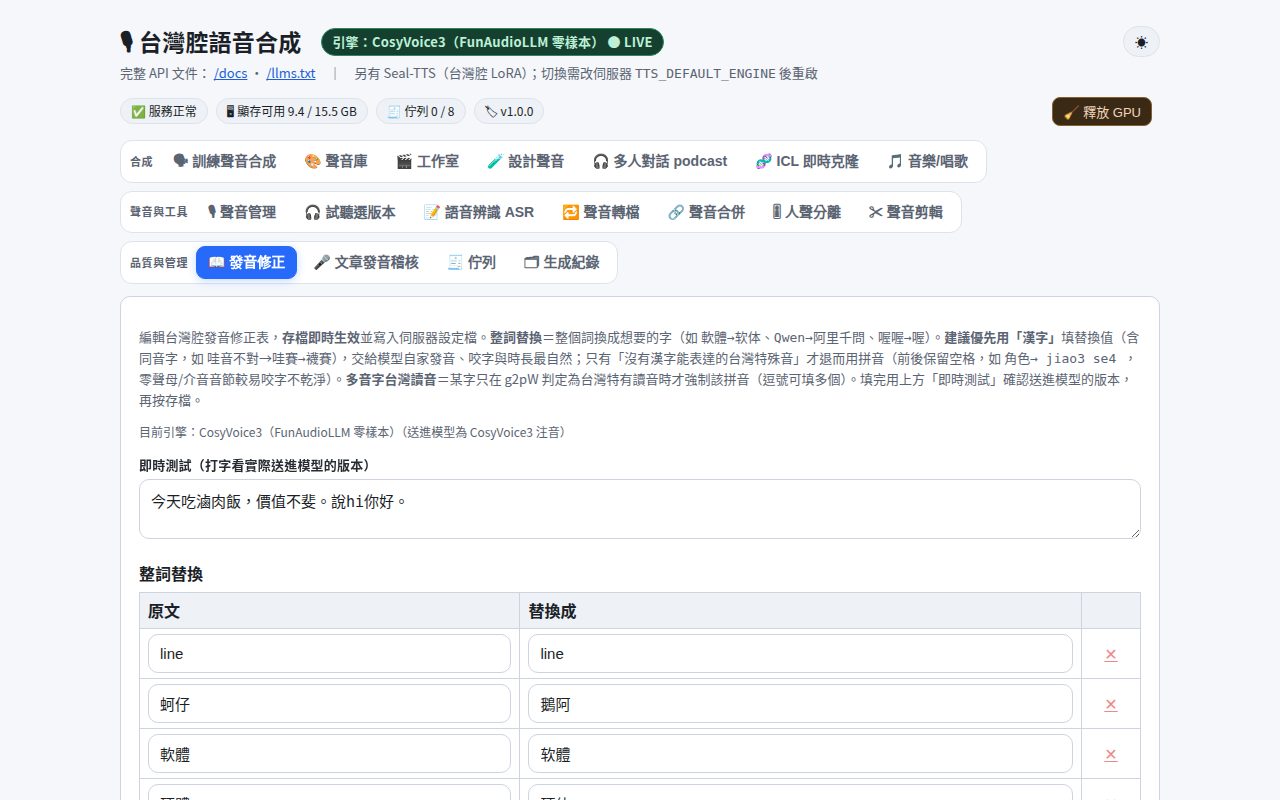
実際の稼働画面です。お客様の情報が入る欄はマスクしています。 画像をタップすると原寸で表示します。
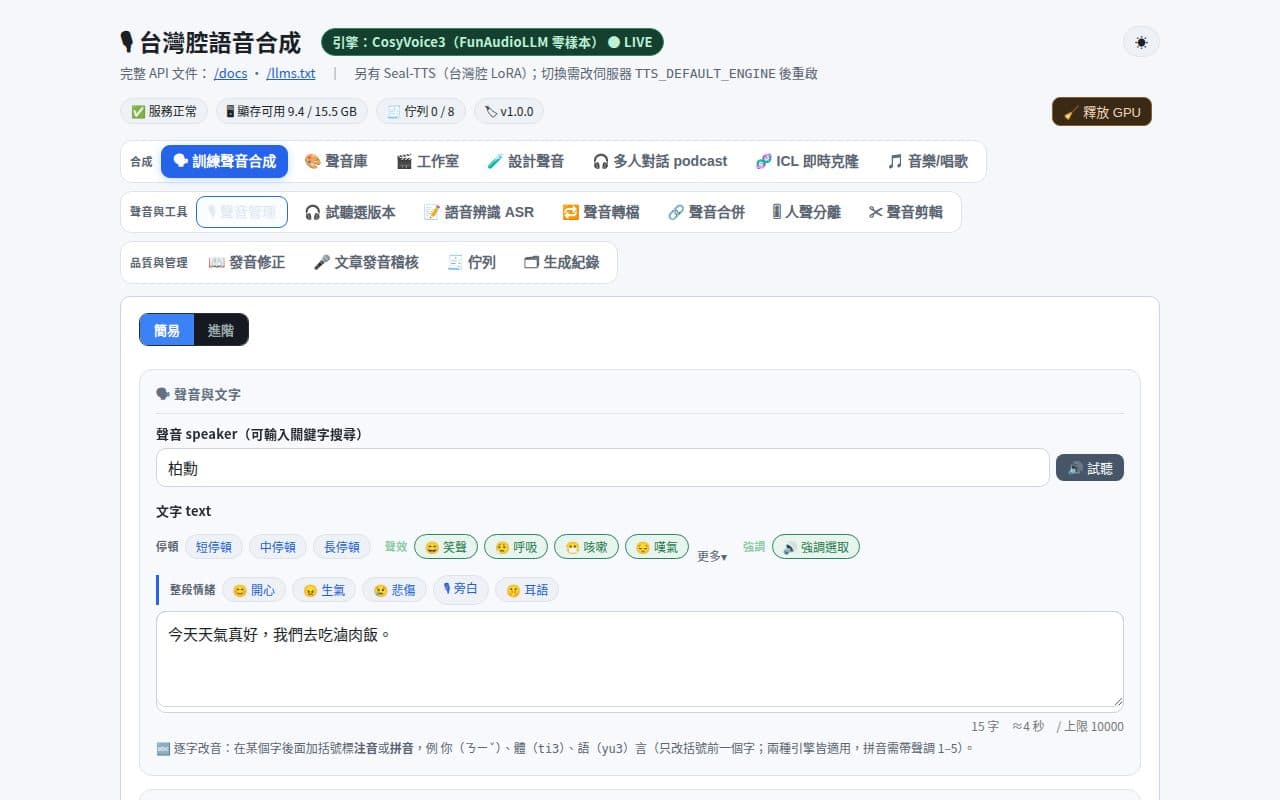
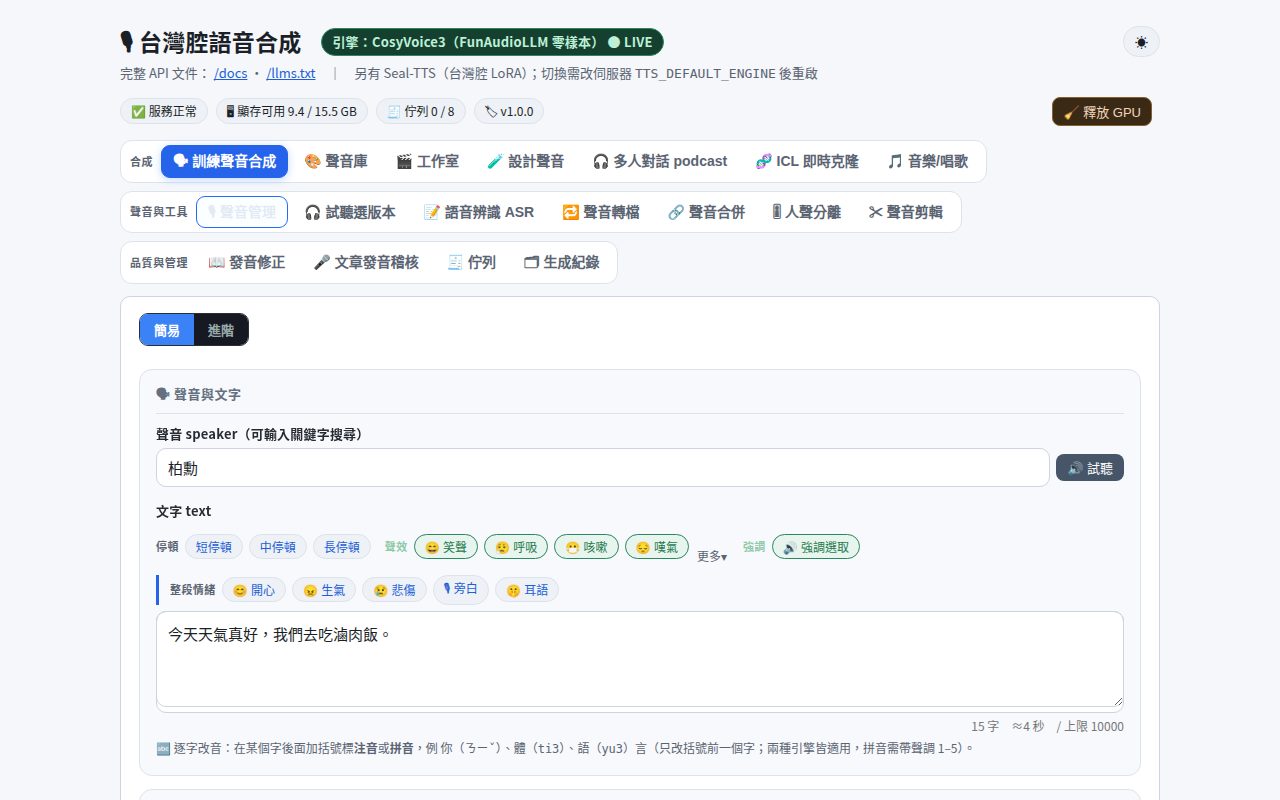
学習済み音声の合成:学習した声を選び、テキストに間や感情を加えて合成。 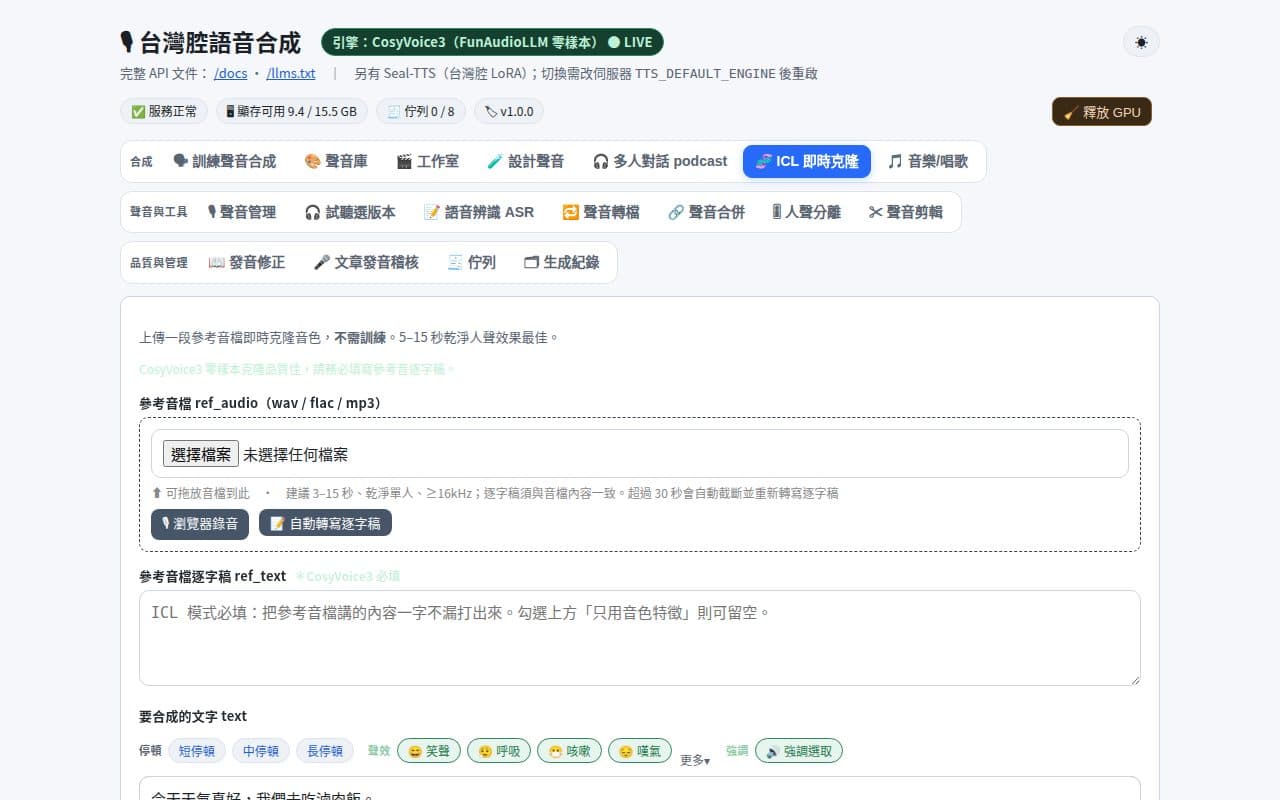
ICL 即時クローン:3〜15 秒の参照音声と書き起こしをアップロードし、学習なしで声を試聴。 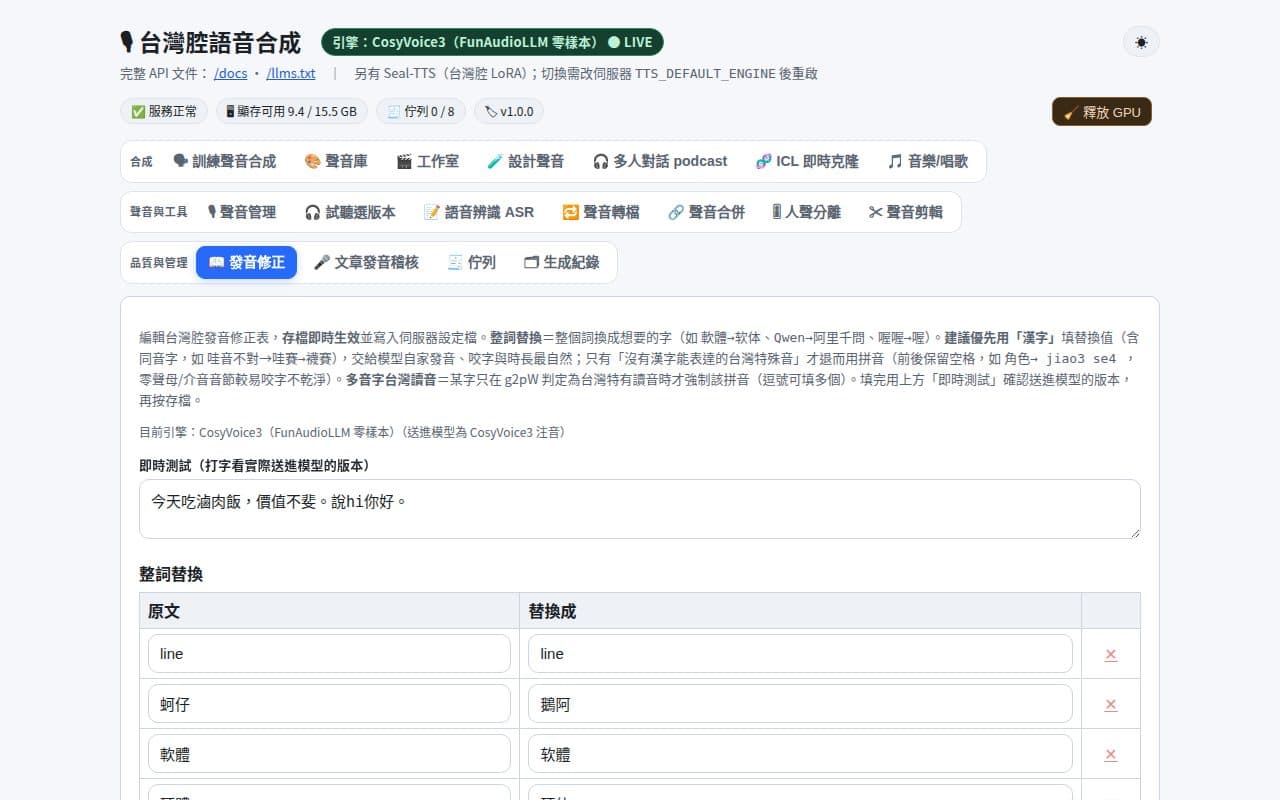
発音修正:台湾の用語向けの語単位置換表。保存するとすべての声に適用されます。
話すバーチャルキャラクター
学習した声をバーチャルキャラクターに使った例です。セリフをキャラクターの声で読み上げ、口の動きを合わせ、字幕も焼き込んでいます。
あいさつ:レコード店でカメラに向かって自己紹介し、フォローを呼びかける 8 秒のセリフ。字幕も声に合わせて表示されます。 リップシンクのアップ:眼鏡の男性がカメラに向かって話します。ここまで寄っても口の動きと声が合っています。 週末の Vlog:公園を歩きながら、ペースを落とす 3 つのコツを話す 37 秒。カットが変わっても顔と声は同じ人のままです。
ほかの実績
同じサービスの事例を先に並べています。
オンプレミスモデル
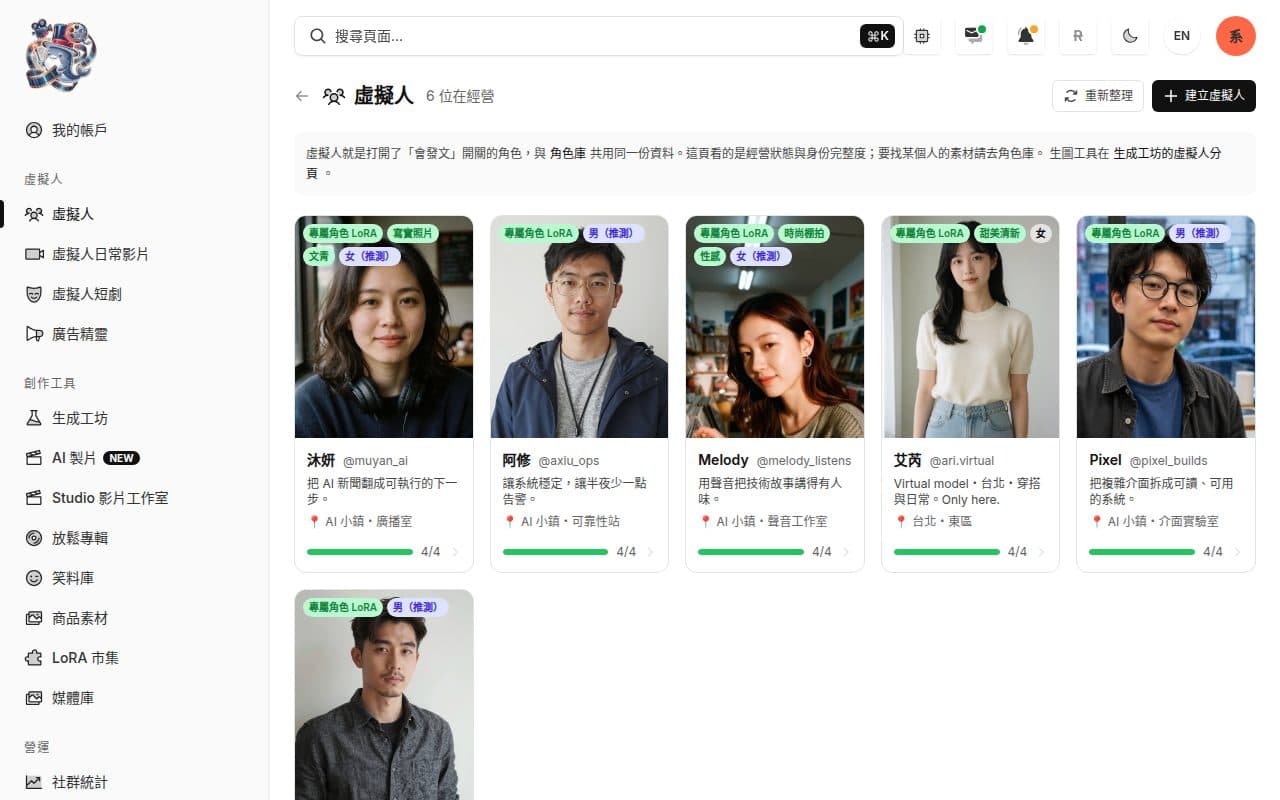
バーチャルヒューマンと AI メディア生成プラットフォーム
自社の GPU サーバーで動く生成プラットフォーム。バーチャルヒューマンごとに専用 LoRA があり、シーンや衣装が変わっても同じ顔のまま、日常のショート動画を撮り、複数人のショートドラマを演じ、セリフは本人の声でリップシンクします。テーマ・ニュース・スライドからナレーションと字幕付きの動画を作ったり、インストゥルメンタルのアルバムを丸ごと作ったりもできます。画像・動画・音声・音楽はすべてローカル GPU で生成します。
- バーチャルヒューマン:キャラクターごとに LoRA を 1 つ。シーンや衣装が変わっても同じ顔で、それぞれ声と人物設定あり
- ショート動画とドラマ:AI が台本、絵コンテ、画像、動画の順に作り、各段階で止めて確認・修正・やり直しが可能
ComfyUI · Z-Image · Krea 2 · Wan 2.2 · LTX · ACE-Step · ローカル GPU
詳しく見るオンプレ AI モデル活用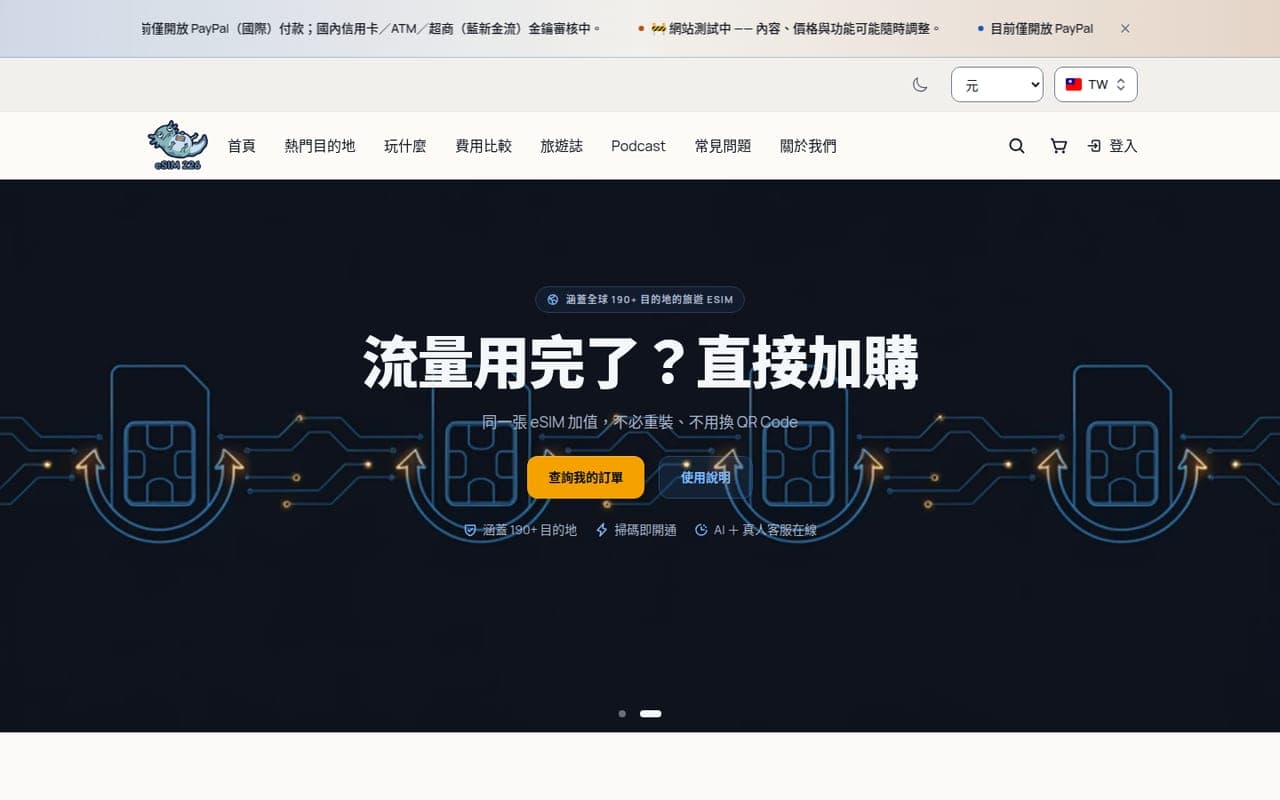
管理システム
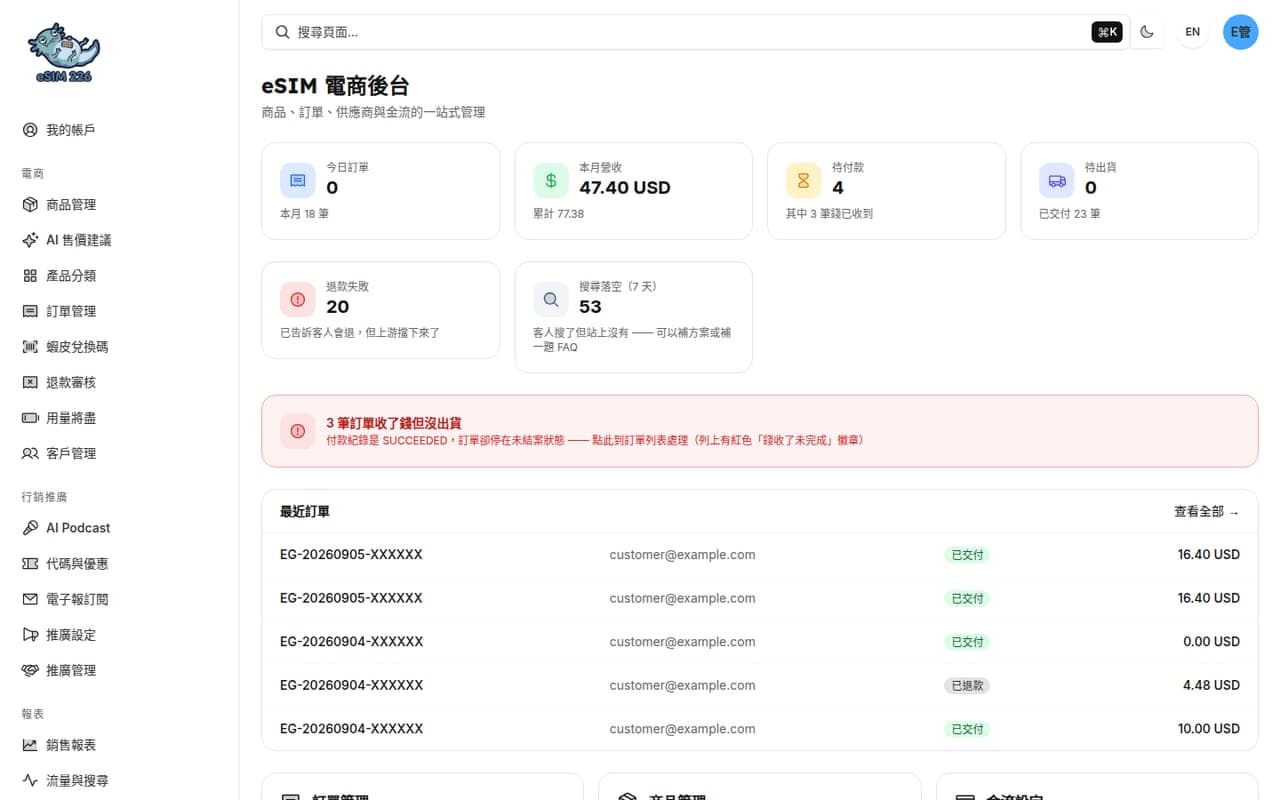
eSIM 管理画面
同じ EC の運用側。商品・価格・注文・返金・サプライヤー・決済を一箇所で。「入金済みなのに未発送」のような事故を、聞かれる前に自分から出してきます。
- 本日の注文、売上、未入金、未発送がひと目で分かる
- AI による価格提案と一括の公開・非公開
Next.js · PostgreSQL · Keycloak · GA4 Data API
詳しく見るEC サイト