地端模型解決方案
虛擬人、AI 影片、配音與音樂,在你自己的 GPU 上生成
把開源模型架在你的 GPU 主機上:替虛擬人訓練專屬 LoRA,換場景、換衣服都是同一張臉,讓他們拍日常短片、演短劇並用自己的聲音對嘴;從一個主題、一篇新聞或一份簡報做出有配音字幕的影片;也能訓練專屬聲音、生成配樂、把錄音轉成逐字稿。圖片、影片與聲音都在你的機器上生成,也沒有按次計費。
生成成果
用這個平台實際生成的短片:第一支是 AI 廣告;接著三支是虛擬人開口說話,台詞用角色的聲音、對嘴、燒上字幕;最後三支是以虛擬人的一張關鍵影格當首幀做圖生影片(MiniMax H3),每支 5 秒,沒有剪輯。
AI 廣告:帶三歲小孩去關西的親子旅遊廣告,58 秒、11 段畫面,每段有標題和字幕,最後一幕收在「立即索取行程表」。 打招呼:在唱片行對著鏡頭自我介紹、請大家追蹤,一句 8 秒的台詞,字幕跟著聲音走。 對嘴特寫:戴眼鏡的男生對鏡頭說話,臉拍得這麼近,嘴型和聲音一樣對得上。 週末 vlog:在公園邊走邊聊三個放慢腳步的小方法,37 秒換了好幾個鏡頭,臉和聲音從頭到尾是同一個人。 公園步道:她邊笑邊走向鏡頭,臉、衣服與光線都跟首幀那張關鍵影格一致。 整理行李:手扶行李箱,低頭笑了一下再抬頭看鏡頭;房間與晨光從頭到尾沒有走樣。 咖啡店:端起咖啡喝一口,鏡頭慢慢推近到她對鏡頭微笑;配樂與環境音也是模型一起生成的。
適合
- 要大量產出圖片、語音或影片,按次計費的雲端服務算下來太貴
- 錄音、影像或逐字稿屬於敏感資料,不能送到第三方
- 需要固定的品牌聲音或代言人形象,每次輸出都要一致
不適合
- 一個月只做幾支,用現成雲端服務更划算
- 沒有被授權的聲音或肖像素材
我們會交付
- 01虛擬人:用授權的素材訓練專屬角色 LoRA,換場景、換衣服都是同一張臉,聲音與人設一起設定好
- 02虛擬人影片:直式日常短片,或 2~4 位同框的生活短劇;台詞用各自的聲音對嘴,劇本、分鏡、畫面每一步都能停下來改
- 03AI 製片:從主題、新聞、Blog 或 PDF/簡報開始,AI 寫腳本、挑畫面、配音上字幕,再用時間軸剪成片
- 04生成工坊:文生圖、圖生圖、修圖、換裝、圖生影片、配樂與語音,模型可以切換,成品自動存進媒體庫
- 05聲音與剪輯:用錄音訓練專屬音色;會議、客服錄音轉逐字稿,含時間軸與講者分離;Podcast 與影片剪掉空白與重複,輸出短版與字幕
- 06部署與介面:跑在你的 GPU 主機,或我們替你代購的雲端 GPU;附 GPU 佇列與顯存監看、API 與 MCP 工具;寫腳本可以接 Claude,也可以全用本機模型
實際畫面
「虛擬人與 AI 影像生成平台」的實際畫面,點圖片可以看原尺寸。
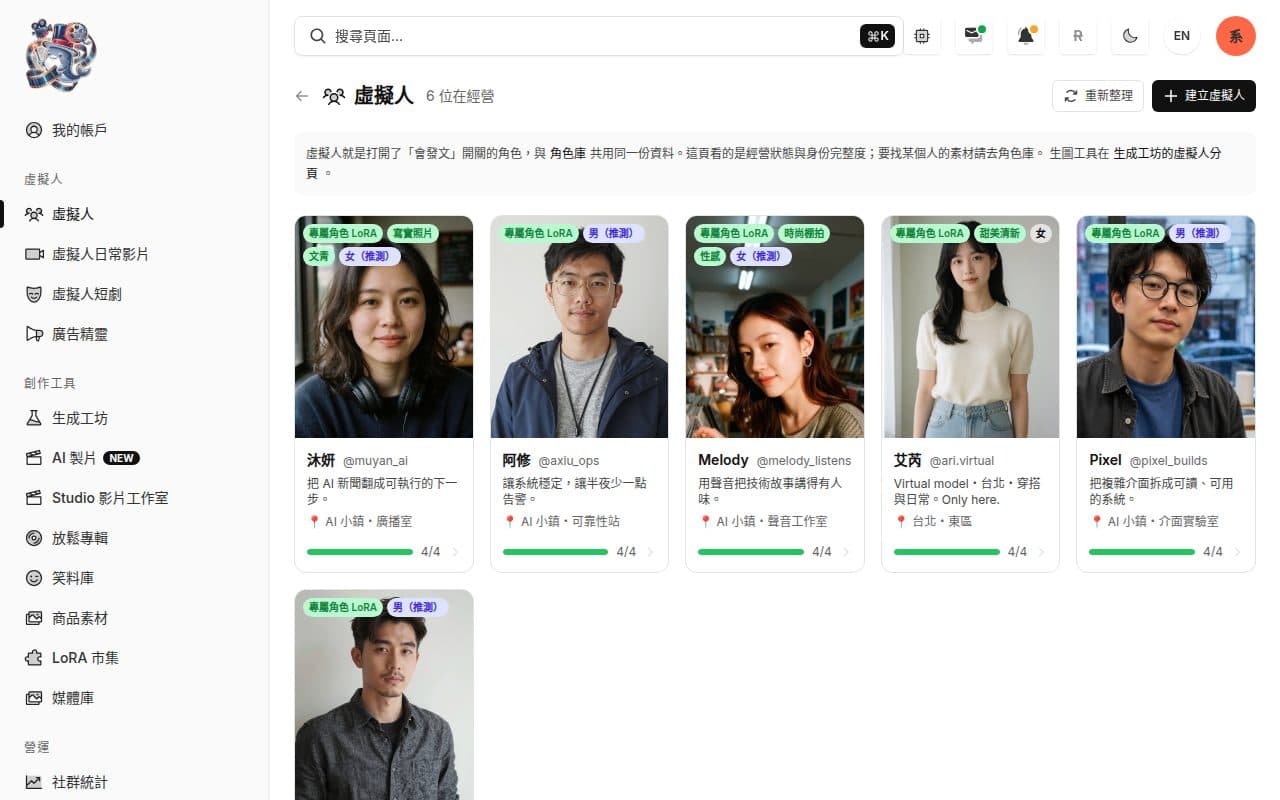
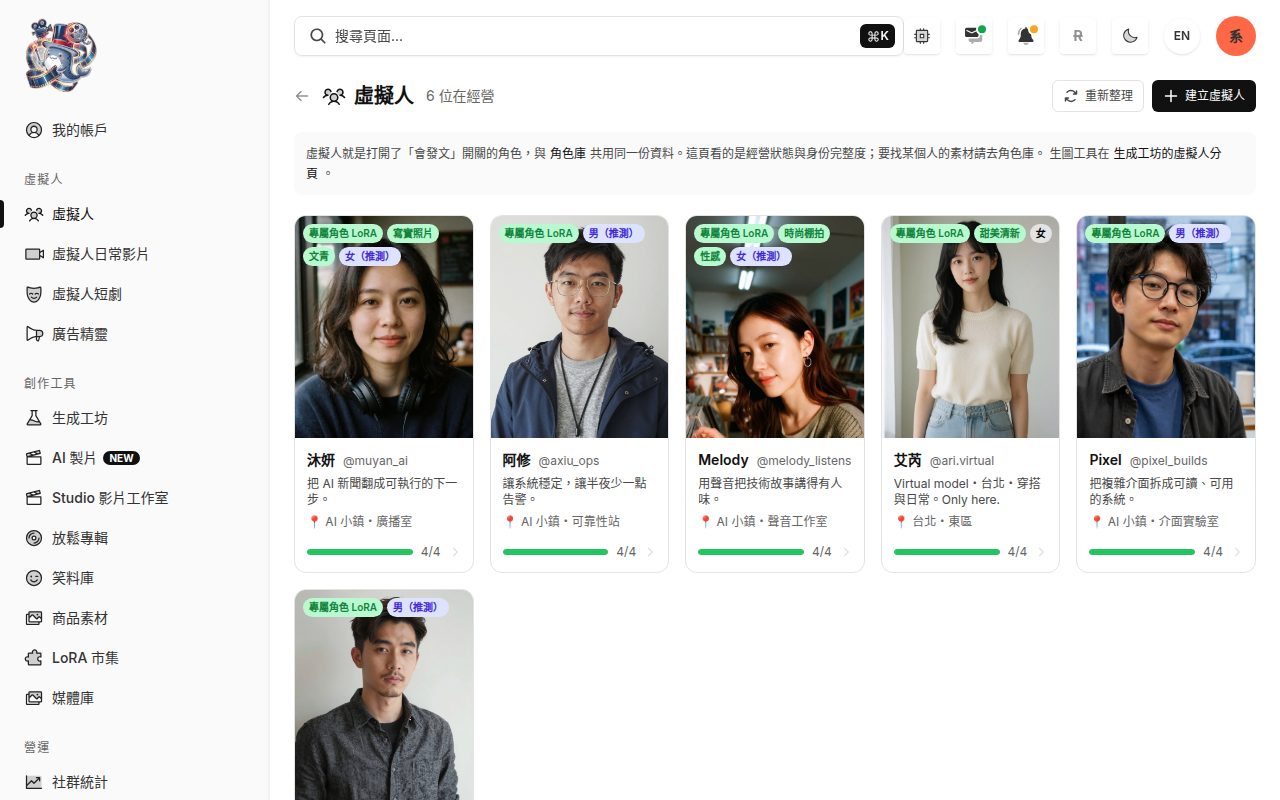
虛擬人:每位角色都有專屬 LoRA、人設與社群帳號,素材完整度一眼看得到。 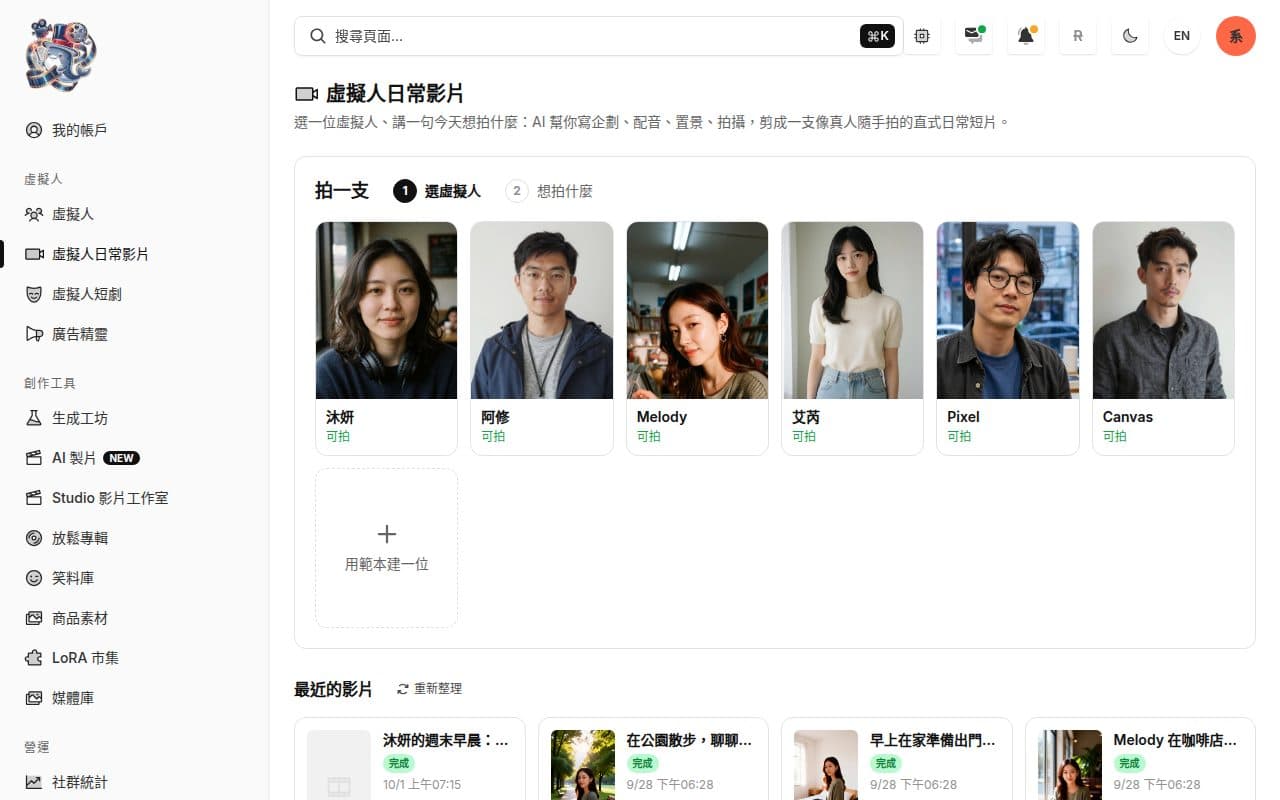
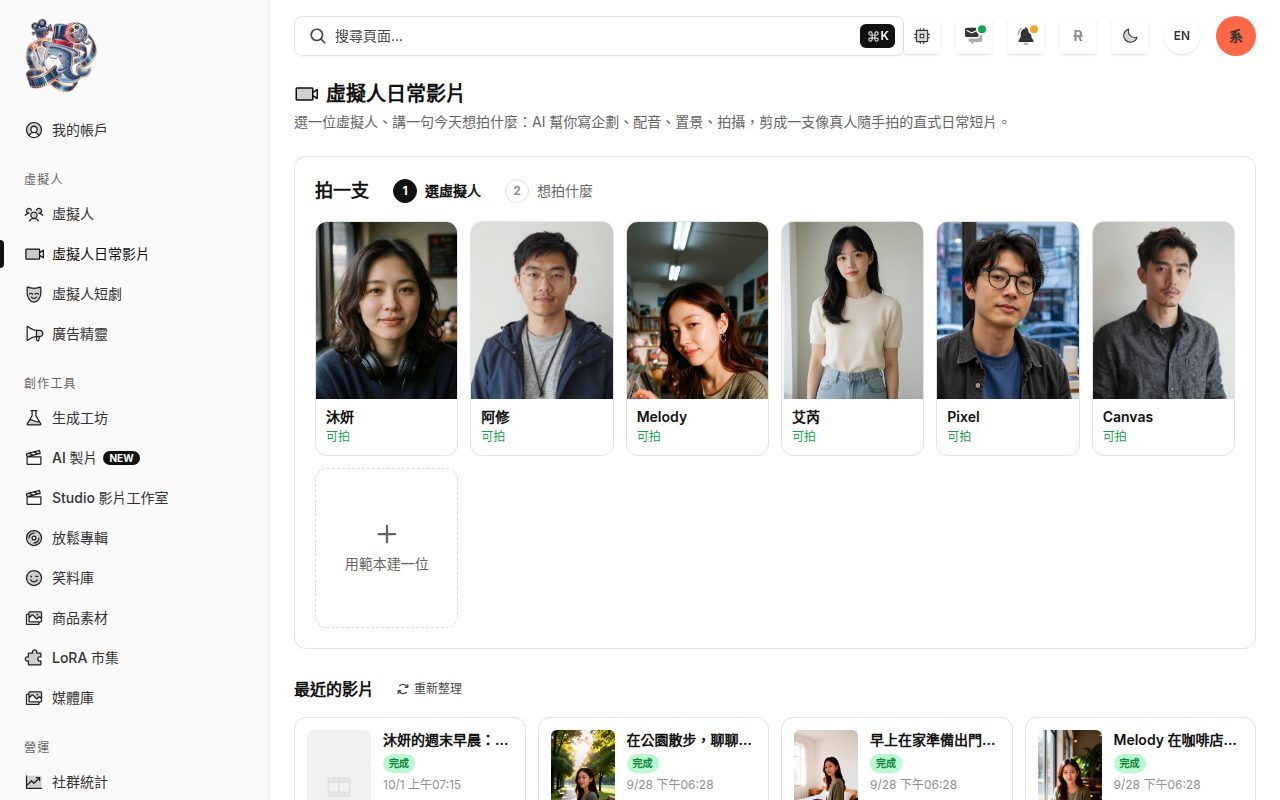
虛擬人日常影片:選一位虛擬人、講一句今天想拍什麼,剪成像隨手拍的直式短片。 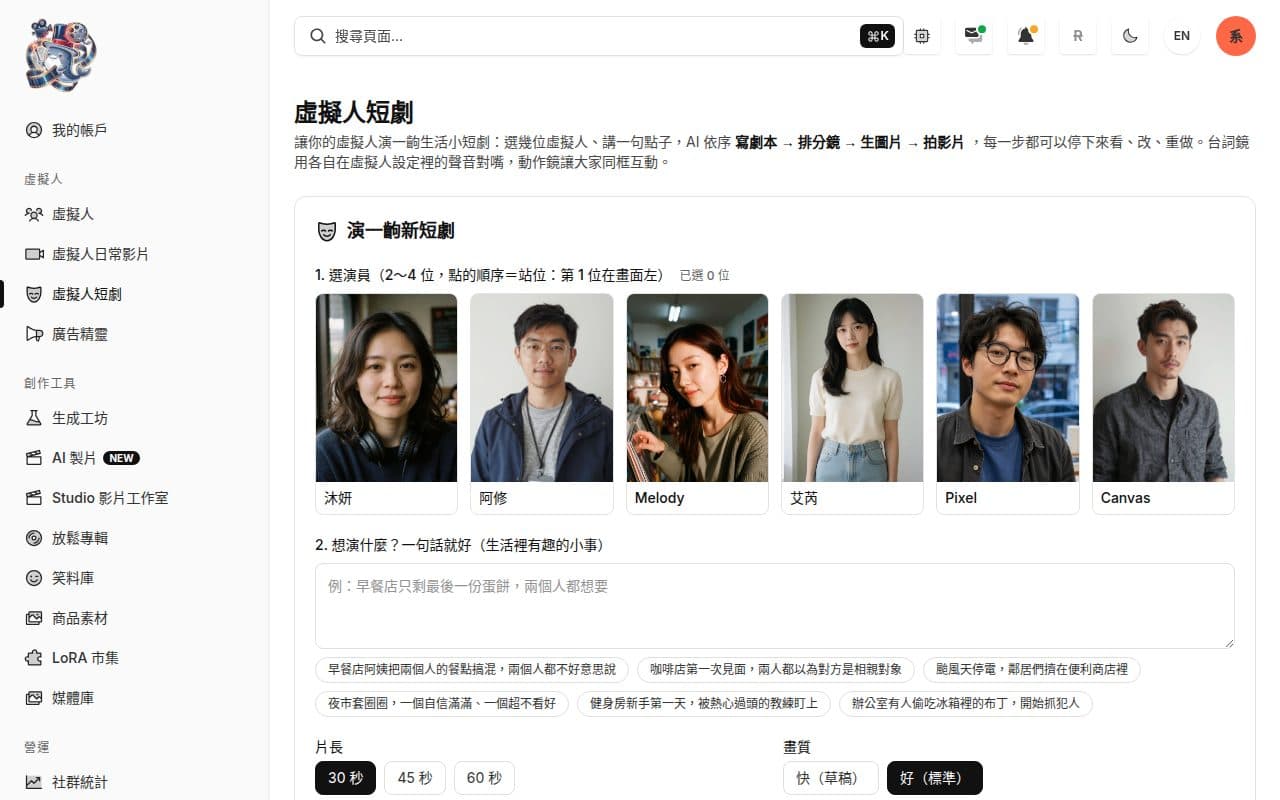
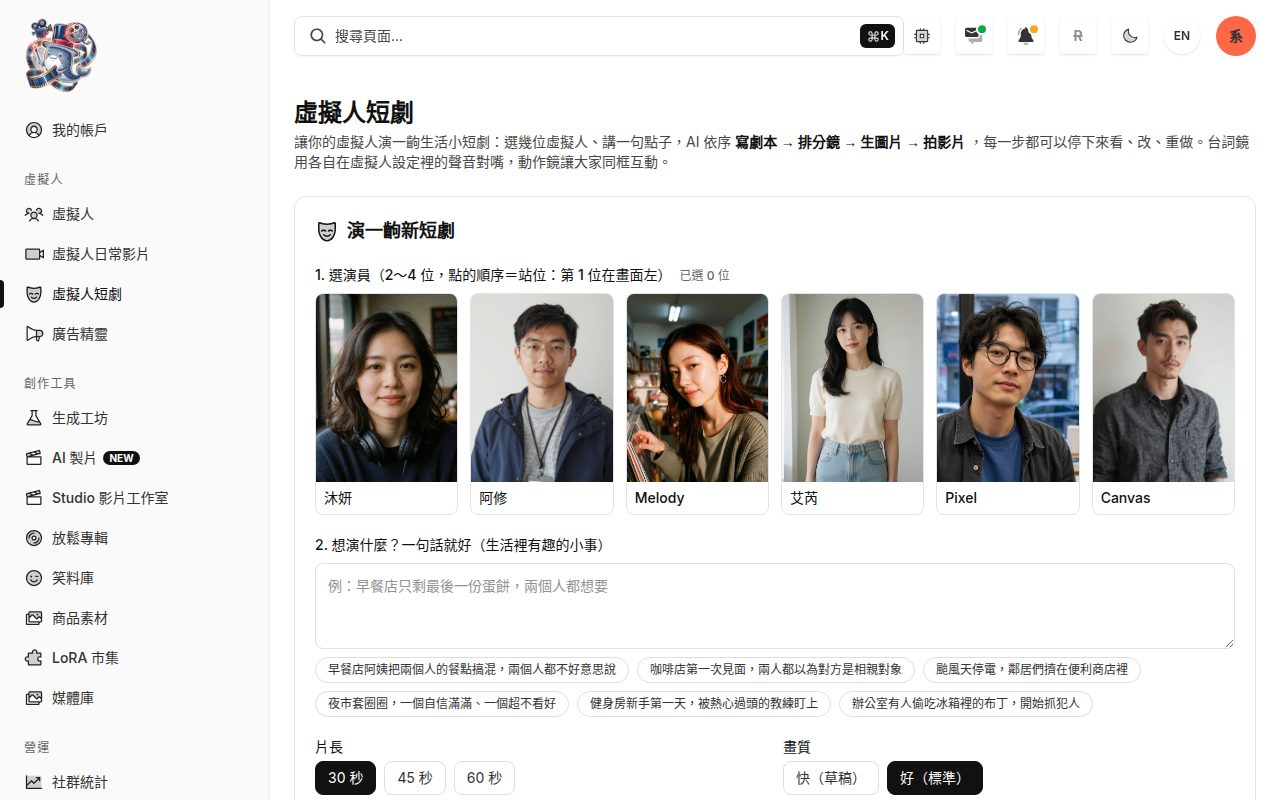
虛擬人短劇:選 2~4 位演員、講一句點子,劇本、分鏡、圖片、影片逐步確認。 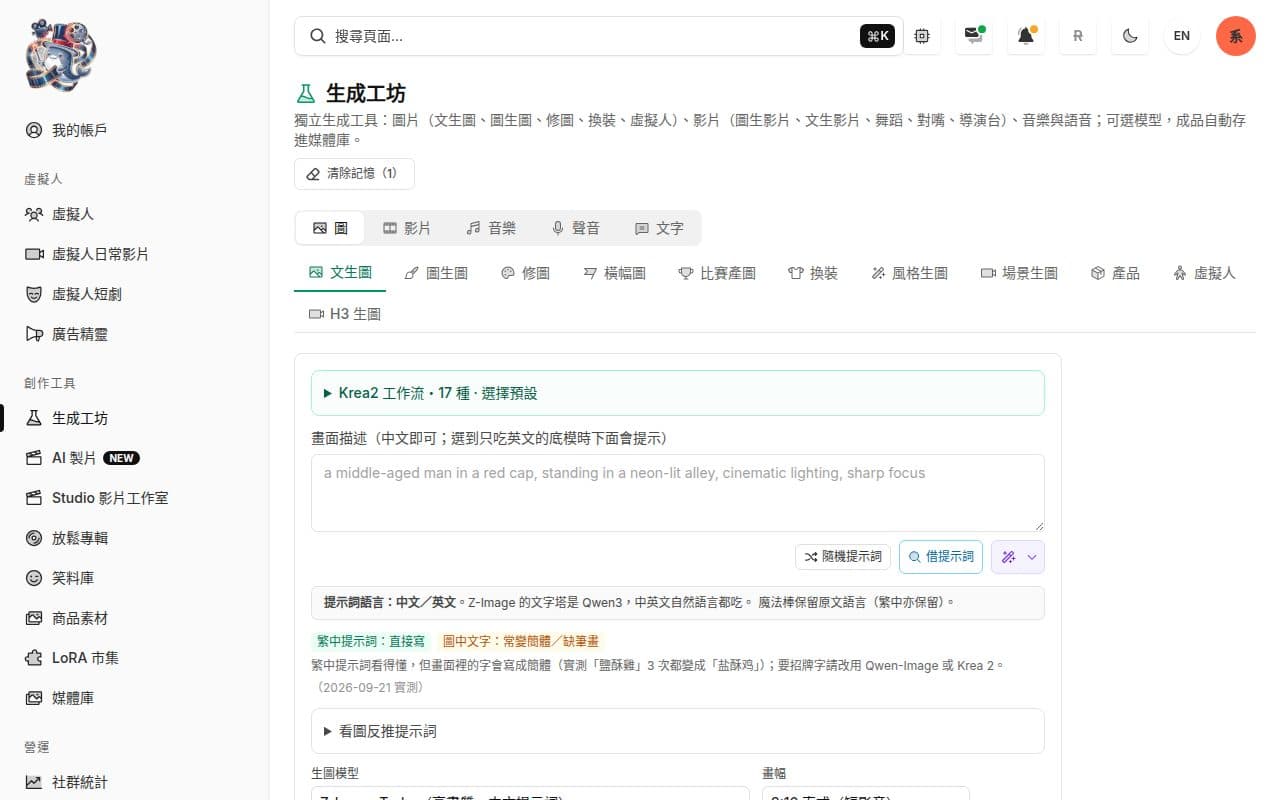
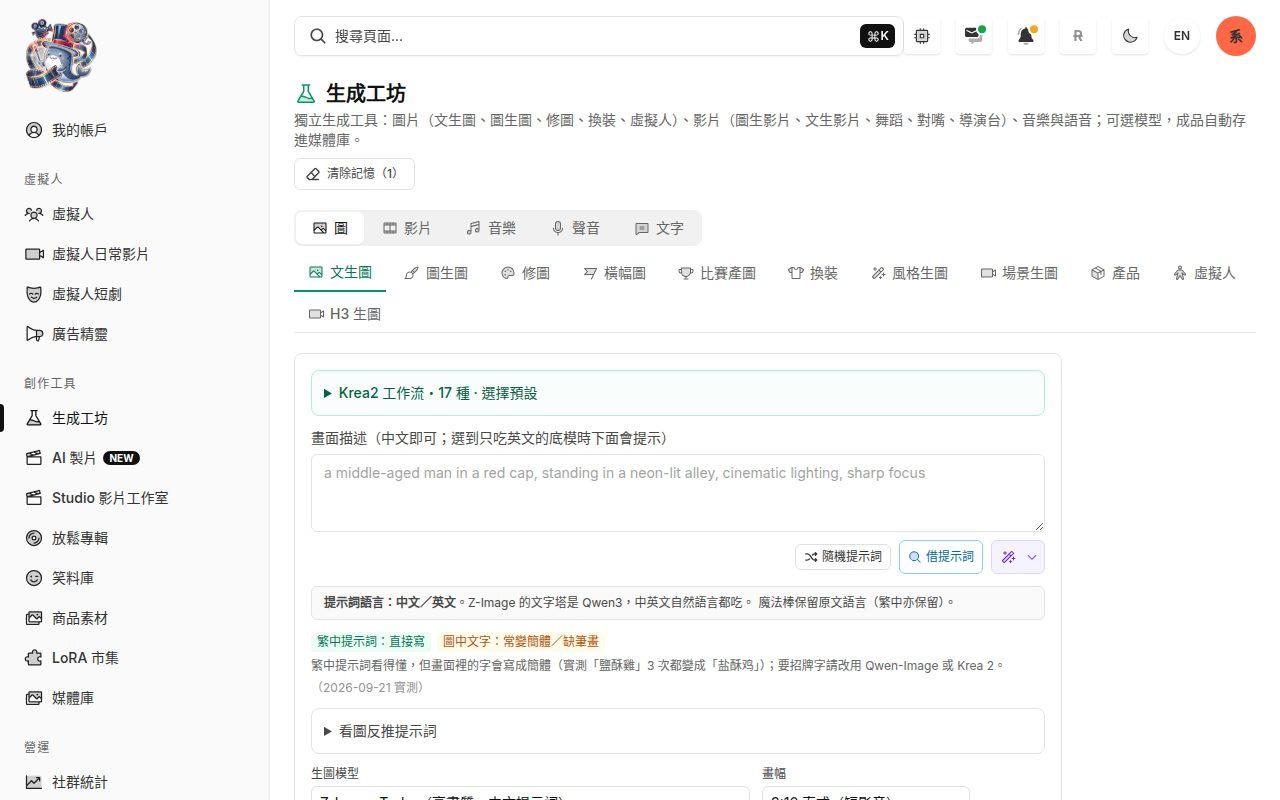
生成工坊:圖、影片、音樂、聲音分頁,生圖模型可以切換,成品自動存進媒體庫。 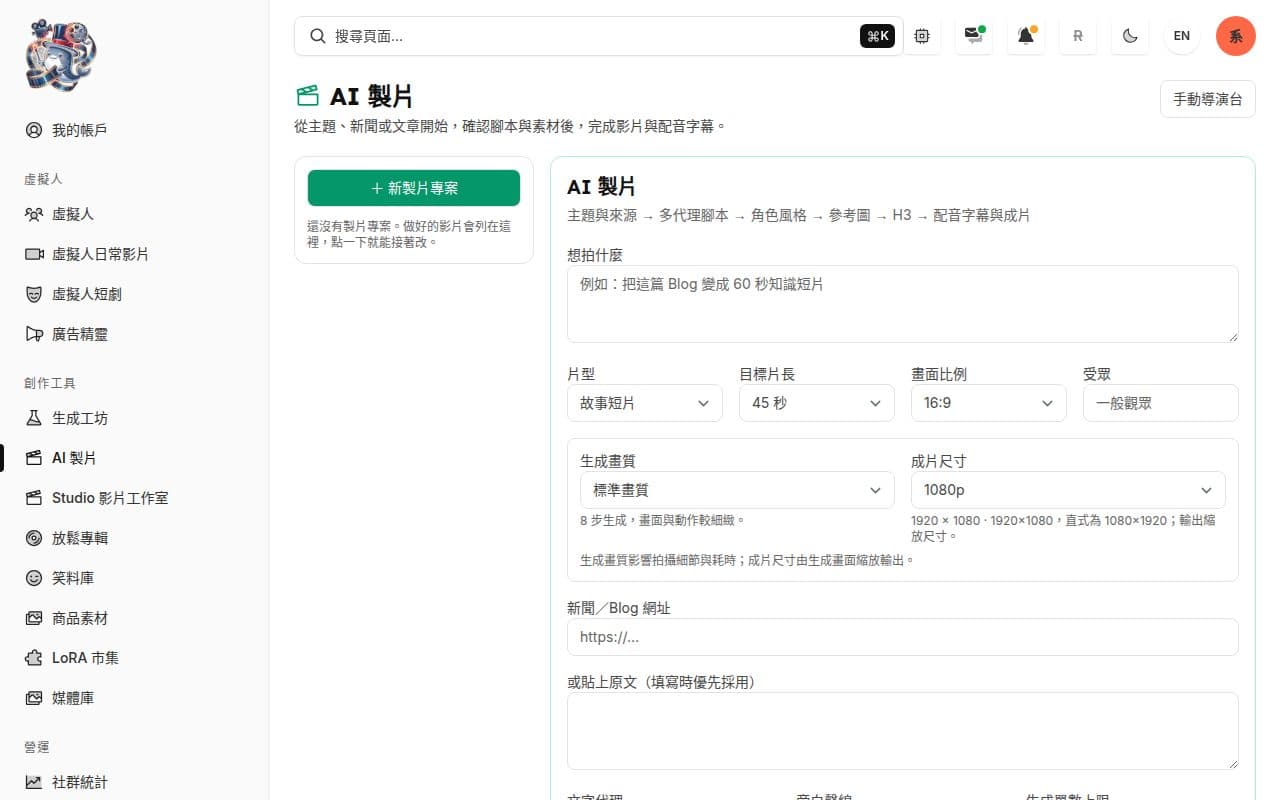
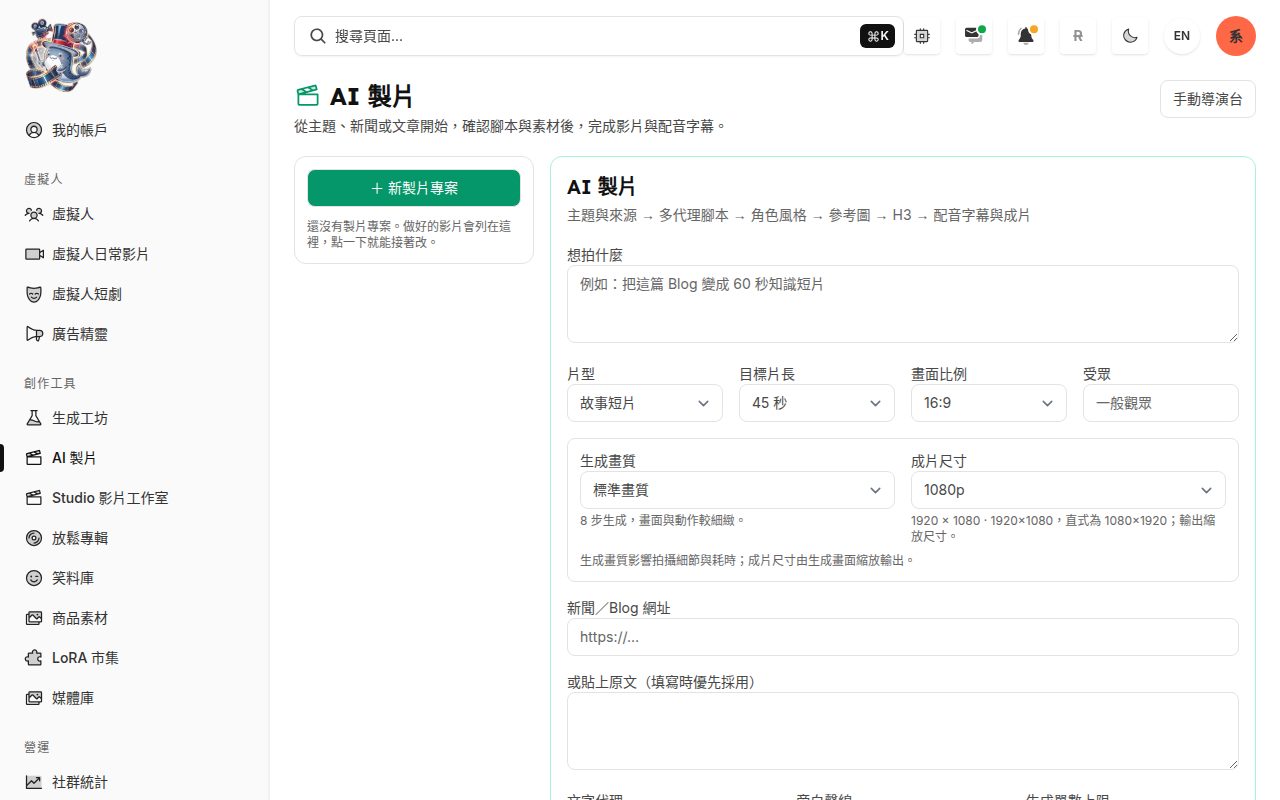
AI 製片:從主題、新聞或 Blog 開始,多個 AI 代理寫腳本,最後配音、上字幕成片。 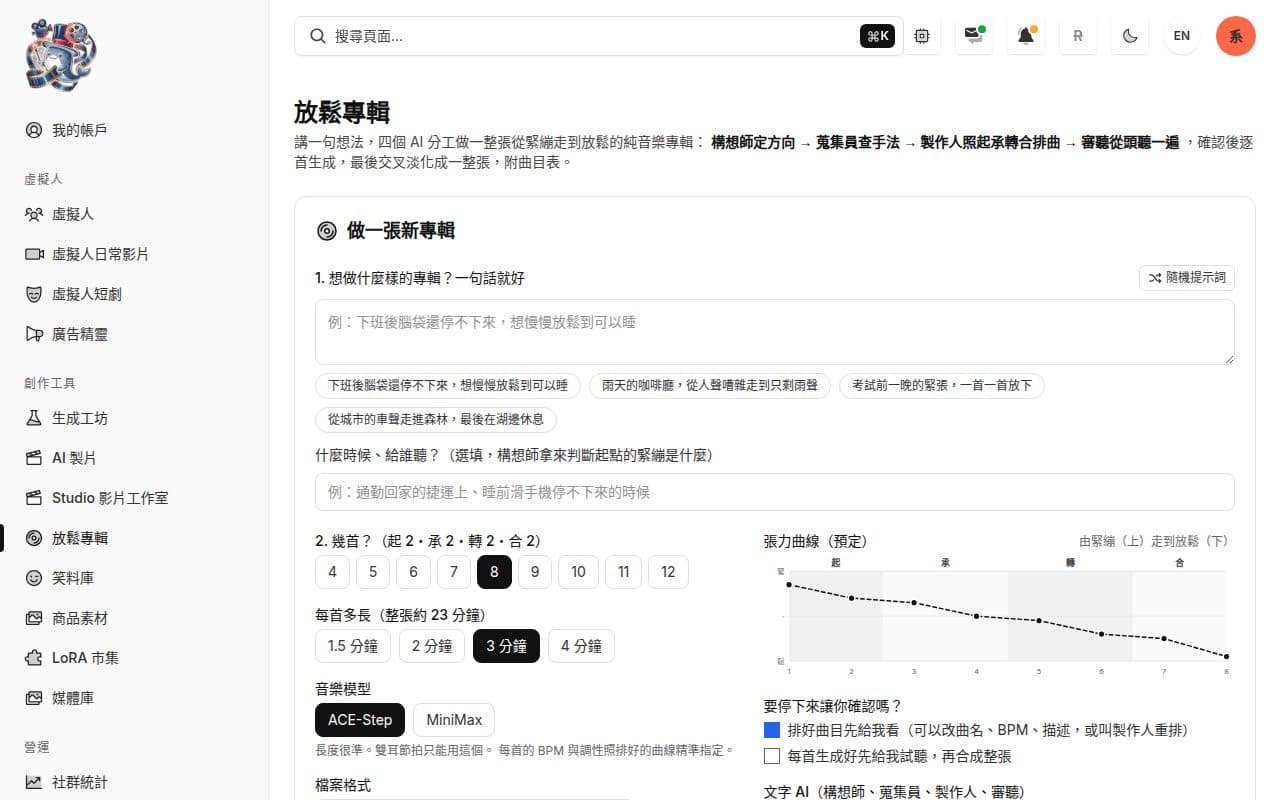
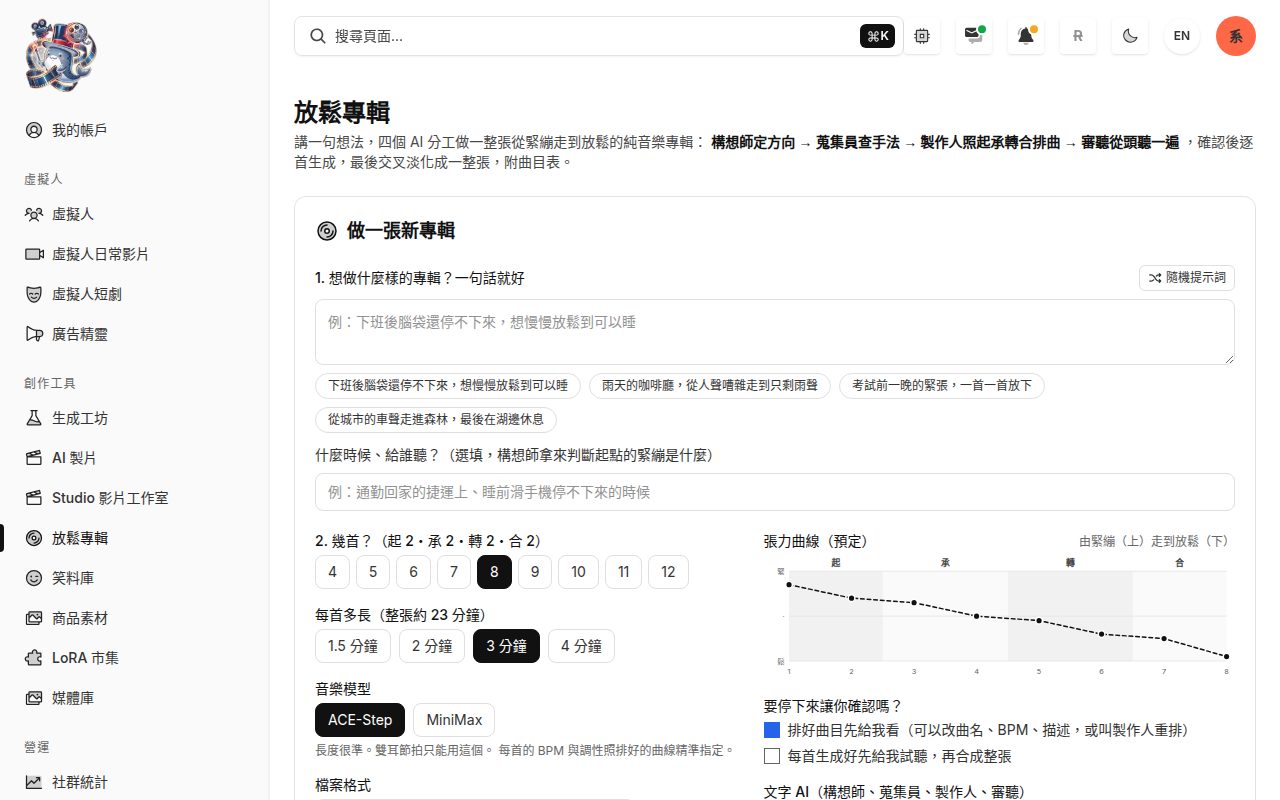
放鬆專輯:四個 AI 分工排出從緊繃到放鬆的曲序,再用 ACE-Step 逐首生成。
相關文章
負責人部落格上的實作文章,記錄做法與遇到的問題。
相關作品
我們自己在營運或公開發佈、跟這項服務同類型的東西。
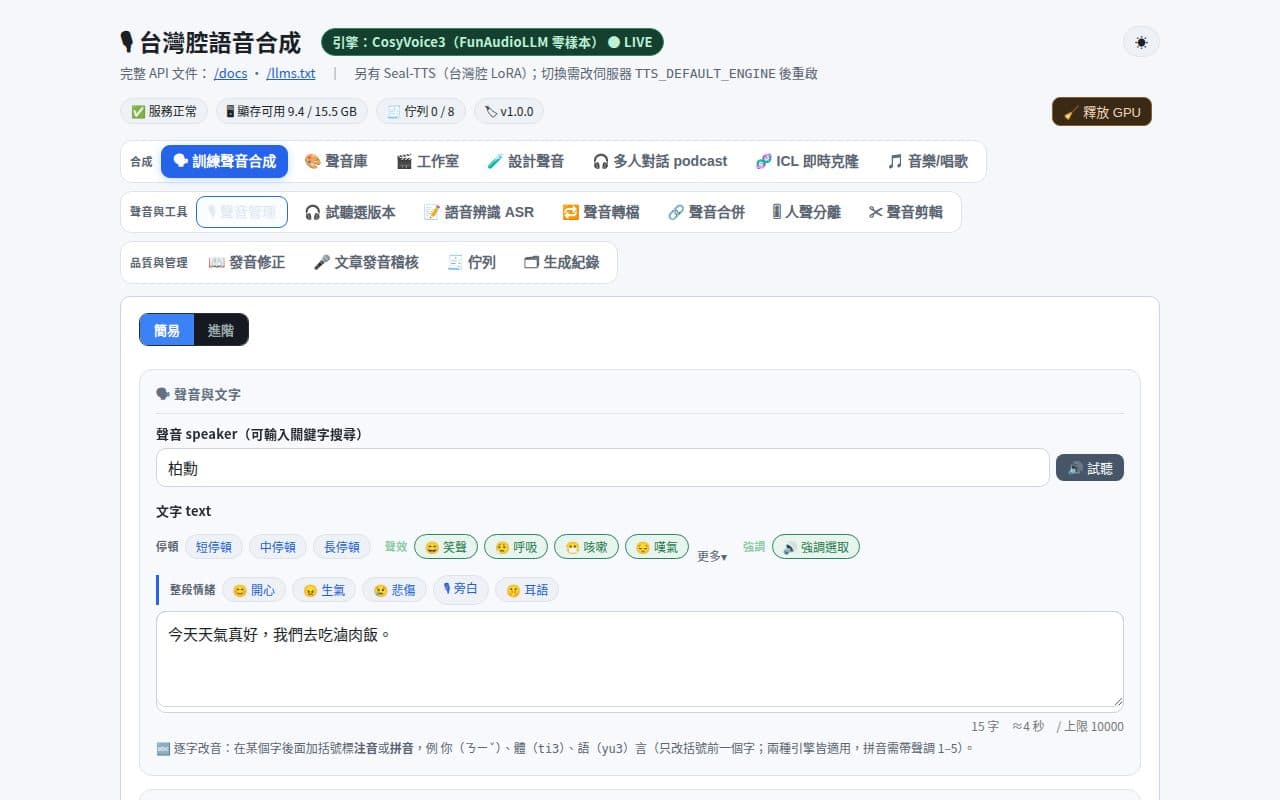
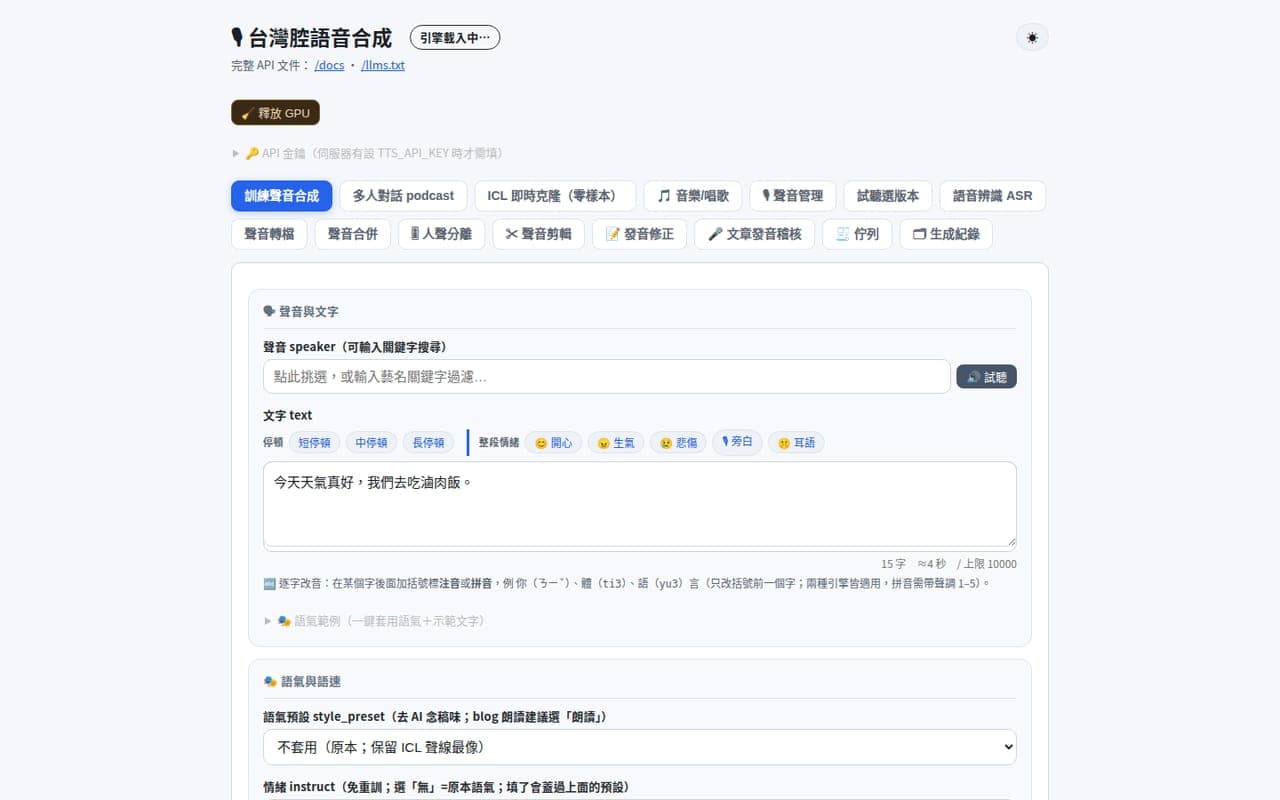
Seal-TTS 台灣腔語音平台
架在本機 GPU 的語音平台:用錄音訓練專屬聲音、零樣本即時克隆、多人對話 podcast、語音辨識、人聲分離與發音修正。AgentHub 的 LINE 語音推播使用它合成。
- Qwen3-TTS
- CosyVoice3
- 本機 GPU
- MCP
剪掉 podcast 的贅字與口吃:用本機的 faster-whisper 辨識、demucs 人聲分離,平衡音量並保留呼吸,輸出前可以逐個接縫試聽。全部在本機執行。
- faster-whisper
- demucs
- Rust
- ffmpeg
- 開源
在影片裡選一個東西(打字、點選,或交給 AI 挑),逐幀追蹤後幫它打碼、換成你的圖片或影片,或用其他幀拍到的背景把它移除。另有序列剪輯與本機字幕,全部在自己的 GPU 上跑,影片不上傳。
- SAM 2.1
- faster-whisper
- MCP
- 本機 GPU
- MIT